Das Onboarding eines KI-Agenten ist die Prüfphase zwischen Bereitstellung und verlässlichem Betrieb. Benennen Sie Prüfperson, Rhythmus und Kriterien vor geringerer Aufsicht. Der folgende 30-Tage-Plan ist ein anzupassendes Beispiel. Weder ein Kalendertag noch eine allgemeine Branchenprognose beweist Einsatzreife.
Die Implementierung ist abgeschlossen. Der Agent ist live. Drei Wochen später nutzt das Team ihn nicht mehr — nicht weil der Agent gescheitert ist, sondern weil niemand damit beauftragt wurde, seine Ausgaben zu überprüfen, niemand die Anweisungen bei realen Grenzfällen aktualisiert hat und niemand definiert hat, wie „korrekte Funktion" an Tag 30 aussehen sollte. Die Liveschaltung wurde als Ziellinie betrachtet. Das Onboarding hätte dort beginnen sollen.
Was bedeutet das Onboarding eines KI-Agenten?
Das Onboarding eines KI-Agenten ist nicht dasselbe wie dessen Konfiguration. Die Konfiguration ist die technische Arbeit vor der Liveschaltung: Tools verbinden, Anweisungen schreiben, Ausgaben testen. Das Onboarding ist das, was danach kommt — die Integration des Agenten in die tatsächliche Arbeitsweise des Teams.
Das Briefing ist ebenfalls ein separater Schritt. Ein Brief teilt dem Agenten mit, was er tun soll. Das Onboarding vermittelt dem Team, wie es mit dem Agenten zusammenarbeitet. Das Schreiben effektiver erster Anweisungen ist eine Voraussetzung für das Onboarding, kein Ersatz dafür.
Ein effektives Onboarding hat drei Bestandteile. Erstens: ein namentlich benannter Reviewer — eine Person, kein Komitee, dessen wiederkehrende Aufgabe die Überprüfung der Agentenausgaben umfasst. Zweitens: ein definierter Überprüfungsrhythmus — wie oft Ausgaben überprüft werden, wie viele, und wonach gesucht wird. Drittens: eine schriftlich festgelegte Erfolgsdefinition — aufgabenspezifische Kriterien, die der Agent erfüllen muss, bevor die enge Überwachungsphase endet.
Ohne diese drei Komponenten ist die Liveschaltung das Ende des Projekts. Mit ihnen ist sie Tag eins.
Der Unterschied zwischen Konfiguration, Briefing und Onboarding ist wichtig, weil jedes einen anderen Fehlermodus adressiert. Konfigurationsfehler produzieren einen Agenten, der nicht läuft. Briefing-Fehler produzieren einen Agenten, der läuft, aber bei Grenzfällen falsche Ausgaben produziert. Onboarding-Fehler produzieren einen Agenten, der zwei Wochen lang korrekt läuft und dann nicht mehr genutzt wird — weil niemand die Beziehung gepflegt hat, die ihn kalibriert und vertrauenswürdig hält.
Ein Projekt kann Konfiguration und Briefing abschließen, während das Onboarding ohne Verantwortliche bleibt. Prüfzuständigkeit und Akzeptanzkriterien brauchen einen eigenen Platz im Startplan.
Wie sollte man die ersten 30 Tage strukturieren?
Der folgende Prüfplan ist ein Beispiel, keine gemessene Lernkurve und keine allgemeine Akzeptanzschwelle. Passen Sie Zeit, Stichprobe und Aufsicht an die Folgen dieses Workflows an.
Die ersten 30 Tage sind eine Phase des Vertrauensaufbaus. Der Agent wird unter enger Aufsicht betrieben, bis er seine Anweisungen anhand realer Daten nachweislich beherrscht. Die Intensität der Überwachung nimmt gezielt ab, sobald Belege für eine korrekte Kalibrierung vorliegen.
Onboarding ist die bewusst gestaltete enge Überwachungsphase zwischen der Liveschaltung und dem vertrauenswürdigen Betrieb. Ein Agent, der diese Phase überspringt, baut kein Vertrauen auf — er sammelt ungeprüfte Fehler an.
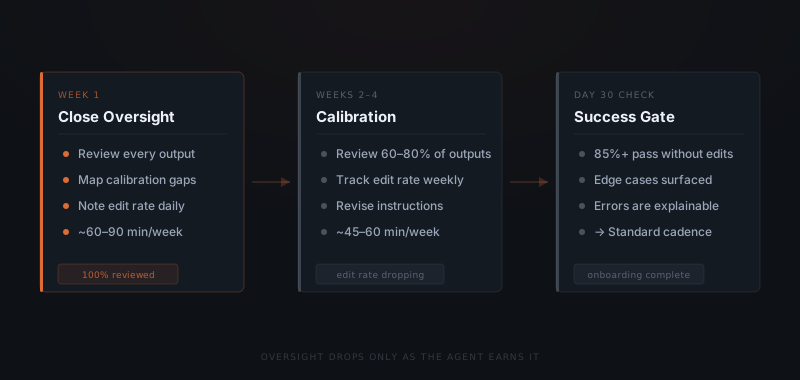
Woche 1: Jede Ausgabe überprüfen. Nicht um alles zu genehmigen — sondern um zu verstehen, wie der Agent mit realen Eingaben umgeht. Notiert wird, welche Ausgaben korrekt und unverändert genehmigt werden, welche vor der Genehmigung bearbeitet werden müssen und welche abgelehnt werden. Am Ende von Woche 1 sollte der Reviewer ein klares Bild der Kalibrierung des Agenten haben.
Wochen 2–4: Reduktion auf 60–80 % Überprüfung, mit Fokus auf Kategorien, die in Woche 1 Fehler erzeugt haben. Die Bearbeitungsrate wird wöchentlich verfolgt. Eine sinkende Bearbeitungsrate kann Verbesserung anzeigen, wenn Eingaben und Prüfmaßstäbe vergleichbar sind. Untersuchen Sie eine gleichbleibende oder steigende Rate, bevor Sie die Aufsicht reduzieren.
Tag 30: Die Erfolgsprüfung anhand des vor der Liveschaltung festgelegten Benchmarks durchführen. In diesem Beispiel sind 85 % unverändert genehmigte Ausgaben ein beispielhaftes Qualitätsziel. Einsatzreife erfordert außerdem repräsentative Eingaben, akzeptable Fehlerkategorien und funktionierende Prüfregeln. Ein blockierender Fehler kann geringere Aufsicht auch bei hoher Gesamtquote verhindern.
| Phase | Überprüfungsintensität | Fokus | Signal zum Weitergehen |
|---|---|---|---|
| Woche 1 | 100 % aller Ausgaben | Verstehen, wie Agent reale Eingaben verarbeitet; alle Fehlerkategorien protokollieren | Bearbeitungsrate-Baseline etabliert; alle Ausgabetypen beobachtet |
| Wochen 2–4 | 60–80 %, Fokus auf Fehlerkategorien | Bearbeitungsrate wöchentlich verfolgen; Anweisungen bei auftretenden Mustern aktualisieren | Sinkende Bearbeitungsrate für zwei aufeinanderfolgende Wochen |
| Tag 30 | Vollständige Benchmark-Prüfung | Bestehensrate gegen vorab geschriebene Erfolgskriterien prüfen | Vereinbartes Qualitätsziel erreicht; keine blockierenden Fehler; repräsentative Eingaben geprüft |
Woran erkennt man, dass der Agent weniger Überwachung benötigt?
Prüfen Sie drei Signale anhand der für diesen Workflow vereinbarten Anforderungen. Eine einzelne Bestehensquote belegt keine Einsatzreife.
Die Liveschaltung ist nicht das Ziel. Sie ist Tag eins der Managementbeziehung.
Stabile Genehmigungsrate. Die Ergebnisse erreichen das vereinbarte Qualitätsziel über eine repräsentative Stichprobe und Prüfzeit. Legen Sie beides für diesen Workflow fest; eine stabile Gesamtquote schließt unzulässige Fehler nicht aus.
Grenzfälle korrekt behandelt. Testen Sie unbekannte und mehrdeutige Eingaben. Bestätigen Sie, dass der Workflow sie im zulässigen Umfang behandelt oder für eine benannte Prüfperson stoppt, statt anzunehmen, dass der Agent jede Ausnahme erkennt.
Fehler sind erklärbar. Der Reviewer kann konkret benennen, welche Ausgabenkategorien noch Verbesserungsbedarf haben und warum. Erscheinen Fehler zufällig oder unvorhersehbar, müssen die Anweisungen weiter überarbeitet werden, bevor die Überwachung reduziert wird.
Wenn diese Anforderungen erfüllt sind, nutzen Sie einen zur Aufgabe passenden laufenden Prüfrhythmus. Behalten Sie nötige Geschäftsfreigaben bei, prüfen Sie Anweisungen bei Geschäftsänderungen und überprüfen Sie den Aufgabenumfang. Den laufenden Rahmen beschreibt wie Sie einen KI-Agenten führen.
Wie sieht eine Erfolgsdefinition in der Praxis aus?
Die vor der Liveschaltung geschriebene Erfolgsdefinition ist keine allgemeine Absichtserklärung — sie ist ein konkreter Benchmark, der an Tag 30 ein binäres Ergebnis produziert: Der Agent besteht, oder er benötigt eine verlängerte Onboarding-Phase.
Eine nützliche Erfolgsdefinition deckt drei Dinge ab:
Bestehensrate. Der Prozentsatz der ohne Bearbeitung genehmigten Ausgaben. Legen Sie den Schwellenwert nach Aufgabe und Fehlerfolgen fest. Das 85%-Ziel im obigen Beispiel ist kein Branchenstandard. Eine Quote allein zeigt nicht, dass ungewöhnliche Fälle korrekt zur Prüfung weitergeleitet werden; testen Sie dieses Verhalten direkt.
Fehlerkategorien-Map. Welche Ausgabekategorien scheitern dürfen und welche nicht. Ein Agent, der eine Follow-up-E-Mail mit einem Formatierungsfehler sendet, ist ein korrigierbarer Fehler. Ein Agent, der eine hochwertige Kundenanfrage an die falsche Warteschlange weiterleitet, ist eine andere Fehlerkategorie. Die Erfolgsdefinition legt fest, welche Fehlertypen an Tag 30 akzeptabel und welche blockierend sind.
Abdeckungsprüfung. Welche Eingabetypen der Agent in den ersten 30 Tagen gesehen hat und ob ein Eingabetyp, für den er konzipiert wurde, nicht aufgetreten ist. Wenn der Agent für fünf Eingabekategorien gebrieft wurde und nur zwei in 30 Tagen aufgetreten sind, bedeutet die Bestehensrate weniger, als wenn alle fünf vertreten wären.
Was passiert, wenn das Onboarding übersprungen wird?
Gartner prognostizierte im Juli 2024, dass mindestens 30 % der generativen KI-Projekte nach dem Proof of Concept bis Ende 2025 aufgegeben würden. Genannt wurden Datenqualität, Risikokontrollen, Kosten und unklarer Nutzen.[1] Das war eine Prognose über generative KI-Projekte, keine gemessene Ausfallquote von Agenten nach dem Start 2026 und kein Nachweis einer Ursache im Onboarding. Prüfen Sie die folgenden Lücken eigenständig.
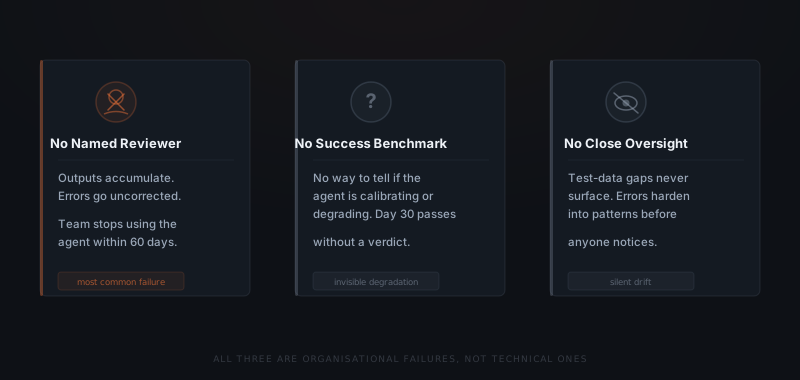
Kein namentlich benannter Reviewer. Der Agent läuft. Ausgaben häufen sich an. Fehler werden nicht korrigiert, weil niemand die Aufgabe des Überprüfens übernimmt. Wenn das Team feststellt, dass die Qualität nachgelassen hat, wird der Agent nicht mehr genutzt — nicht weil die Technologie versagt hat, sondern weil die Managementbeziehung nie aufgebaut wurde.
Keine Erfolgsdefinition. An Tag 30 kann niemand sagen, ob der Agent funktioniert oder sich verschlechtert. Ohne einen vor der Liveschaltung festgelegten Benchmark sieht ein langsam scheiternder Agent genauso aus wie ein gut kalibrierter — bis die Verschlechterung offensichtlich wird.
Keine enge Überwachung in Woche 1. KI-Agenten verhalten sich mit realen Daten anders als mit Testdaten. Eine enge Überwachung in Woche 1 zeigt die Lücken zwischen Test- und Produktionsbetrieb. Ohne diese Überwachung verfestigen sich diese Lücken zu Mustern, bevor sie jemand bemerkt — und das Korrigieren eingefahrener Fehler, nachdem sich das Team daran angepasst hat, ist störender als deren Prävention an der Quelle.
| Übersprungener Onboarding-Schritt | Was das Team beobachtet | Was tatsächlich passiert ist | Wie man sich erholt |
|---|---|---|---|
| Kein namentlich benannter Reviewer | Qualität „scheint in Ordnung" — bis plötzlich nicht mehr | Fehler häuften sich wochenlang ungeprüft an | Einen Reviewer zuweisen; rückwirkende Überprüfung der letzten 30 Tage durchführen |
| Keine Erfolgsdefinition | Unmöglich zu sagen, ob Agent sich kalibriert oder verschlechtert | Keine Basis zum Vergleich; scheiternder Agent sieht aus wie funktionierender | Benchmark nachträglich definieren; Kalibrierungsüberprüfung dagegen durchführen |
| Keine enge Überwachung in Woche 1 | Ersten-Monat-Ausgaben locker genehmigt | Test-zu-Produktion-Lücken haben sich zu konsistenten Fehlermustern verfestigt | Strukturierte Überprüfung der letzten 30 Ausgaben; Anweisungen für jedes identifizierte Muster neu schreiben |
| Kein Anweisungs-Update-Prozess | Agentenausgaben driften von Team-Erwartungen ab | Anweisungen spiegeln nicht mehr das Unternehmen wider | Anweisungs-Review-Verantwortung zuweisen; vollständiges Brief-Audit durchführen |
Wie setzen Sie das Onboarding vor der Liveschaltung auf?
Jeder Onboarding-Fehler ist ein Setup-Fehler vor der Liveschaltung. Der Reviewer, der Überprüfungsrhythmus und der Erfolgsbenchmark müssen existieren, bevor der Agent seine erste Live-Aufgabe übernimmt — nicht nachdem das erste Problem auftaucht.
Zuerst die Erfolgsdefinition schreiben
Vor der Liveschaltung den konkreten Benchmark festlegen, den der Agent an Tag 30 erfüllen muss: Bestehensrate-Schwellenwert, abgedeckte Ausgabekategorien und welche Fehlertypen akzeptabel versus blockierend sind.
Einen namentlich benannten Reviewer zuweisen
Nicht ein Komitee — eine Person. Der Name dieser Person erscheint im Onboarding-Dokument vor der Liveschaltung. Bei Reviewerwechsel muss die Übergabe das laufende Bearbeitungsraten-Protokoll beinhalten.
Woche-1-Überprüfungsblöcke einplanen
Die Woche-1-100%-Überprüfungszeit vor der Liveschaltung im Kalender einplanen. Als Verpflichtung, nicht als Erinnerung. Ohne Kalenderblöcke beim Launch wird Woche-1-Überprüfung zu „wenn Zeit ist" — und das ist gleichbedeutend mit nie.
Das Team über den Scope briefen
Jedes Teammitglied, das mit den Ausgaben des Agenten interagiert, sollte wissen: was der Agent übernimmt, was er nicht übernimmt und wie man etwas meldet, das falsch aussieht.
Den Anweisungs-Update-Prozess definieren
Wer die Anweisungen des Agenten aktualisieren kann, in welchem Zeitrahmen und wie Änderungen protokolliert werden. Unsichtbare Anweisungsänderungen sind die häufigste Quelle unerklärlicher Output-Verschiebungen.
KI-Agenten-Onboarding prüfen als PDF herunterladen
Häufig gestellte Fragen
Was beinhaltet das Onboarding eines KI-Agenten konkret? Onboarding ist die strukturierte Phase zwischen der Liveschaltung und dem vertrauenswürdigen Betrieb. Sie erfordert drei Dinge: einen namentlich benannten Reviewer, der Outputs regelmäßig prüft, einen definierten Überprüfungsrhythmus sowie eine schriftliche Erfolgsdefinition — aufgabenspezifische Kriterien, die der Agent erfüllen muss, bevor die Überwachung reduziert werden kann.
Wie lange dauert das Onboarding eines KI-Agenten? Dieser Beitrag nutzt einen beispielhaften Dreißig-Tage-Plan. Die tatsächliche Einarbeitung hängt von Aufgabe, Eingabevielfalt und Fehlerfolgen ab. Prüfen Sie anfangs eng und reduzieren Sie Aufsicht erst, wenn repräsentative Ergebnisse die vereinbarten Anforderungen erfüllen. Ein Datum oder eine allgemeine 85%-Bestehensquote belegen keine Einsatzreife.
Worauf sollte man bei der Überprüfung von KI-Agenten-Outputs während des Onboardings achten? Drei Kategorien für jeden Output erfassen: ohne Änderungen freigegeben, vor Freigabe bearbeitet oder abgelehnt. Die Korrekturrate Woche für Woche verfolgen. Eine sinkende Rate kann Verbesserung anzeigen, wenn Eingaben und Prüfmaßstäbe vergleichbar sind. Eine gleichbleibende oder steigende Rate ist Anlass, Anweisungen, Eingaben und Prüfprozess zu untersuchen. Bei erforderlichen Korrekturen die Kategorie protokollieren — Format, Tonalität, fehlendes Feld — damit das Muster sichtbar ist.
Was passiert, wenn das Onboarding eines KI-Agenten übersprungen wird? Ohne Prüfperson, Erfolgskriterien und frühe Ergebniskontrollen können Fehler unbemerkt bleiben, und das Team kann den Nutzen nicht beurteilen. Planen Sie die Prüfung und benennen Sie vor dem Start eine verantwortliche Person.
Was ist eine gute Erfolgsdefinition für einen KI-Agenten an Tag 30? Definieren Sie Ergebnisqualität, unzulässige Fehlerarten und die Eingabefälle, die getestet sein müssen. Eine Bestehensquote kann bei Routineaufgaben helfen, muss aber zu den Fehlerfolgen passen. Ein schwerer Fehler kann unabhängig vom Gesamtanteil die Einsatzreife verhindern. Nutzen Sie Tag dreißig als Prüfzeitpunkt, nicht als automatische Freigabe.
Quellen
- Gartner, July 29, 2024 forecast: at least 30% of generative AI projects abandoned after proof of concept by end of 2025. https://www.gartner.com/en/newsroom/press-releases/2024-07-29-gartner-predicts-30-percent-of-generative-ai-projects-will-be-abandoned-after-proof-of-concept-by-end-of-2025