KI-Fehlerzahlen beschreiben unterschiedliche Phasen und Ergebnisse. Fragen Sie damit gezielt nach Aufgabe, Daten, Abnahme und laufender Verantwortung und beurteilen Sie Ihren Ablauf anhand seiner Ergebnisse.
Das erfahren Sie
- Trennen Sie Unternehmen, Projekte und Einsätze.
- Prüfen Sie reale Betriebsbedingungen vor und nach dem Start.
- Benennen Sie die Verantwortung für Stopp, Korrektur und Beendigung.
Es gibt keine einheitliche KI-Implementierungs-Fehlerquote für jeden Betrieb. Aktuelle Forschung zählt unterschiedliche Gruppen, Phasen und Ergebnisse. Trennen Sie aufgegebene Vorhaben, den Übergang eines Versuchs in den Betrieb und messbaren finanziellen Ertrag. Planen Sie daraus die Prüfungen und Zuständigkeiten Ihres Ablaufs.
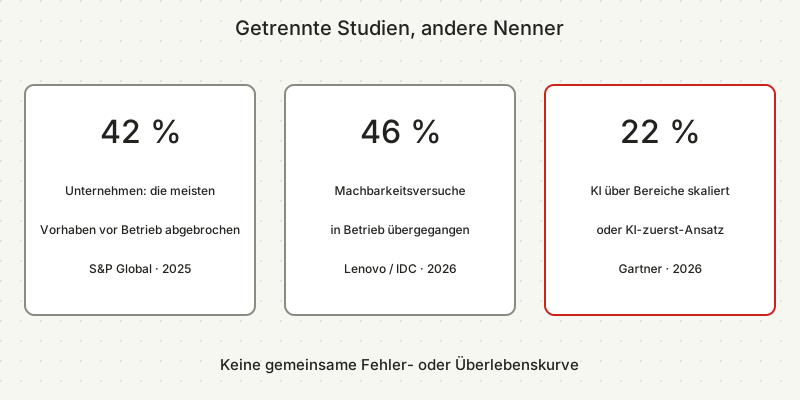
Schlagzeilen zu KI-Fehlerquoten betreffen unterschiedliche Ergebnisse. In S&P Globals Befragung 2025 meldeten 42 % der Unternehmen den Abbruch der meisten KI-Vorhaben vor dem Betrieb, gegenüber 17 % im Vorjahr. Das ist der Anteil von Unternehmen mit einem Muster über ihre Projekte, nicht die Aussage, jedes Projekt scheitere zu 42 %.[6]
Bewahren Sie Phase und Ergebnis auf. Ein beendetes Experiment, eine falsche Live-Handlung und eine Investition ohne messbaren finanziellen Ertrag erfordern unterschiedliche Entscheidungen. Was ein KI-Agent ist hilft bei der Definition der untersuchten Arbeit.
Was misst die KI-Fehlerquote tatsächlich?
Lesen Sie das gemessene Ergebnis vor der Einstufung als Scheitern. S&P Globals Bericht vom Mai 2025 umfasst 1.006 IT- und Geschäftsfachkräfte in Nordamerika und Europa. Neben der unternehmensbezogenen Abbruchquote meldeten Befragte durchschnittlich 46 % eingestellte Projekte zwischen Machbarkeitsnachweis und breiter Nutzung. Die Nenner unterscheiden sich.[6]
Fragen Sie vor einer Fehlerquote nach der Zähleinheit: Unternehmen, Projekte oder Einsätze; erreichter Phase; und Erfolg als technische Erledigung, Start oder finanzielles Ergebnis. Fassen Sie unterschiedliche Werte nicht zu einer allgemeinen Scheiterwahrscheinlichkeit zusammen.
Project NANDAs vorläufiger Bericht vom Juli 2025 beschreibt „keinen Ertrag“ bei 95 % der untersuchten Organisationen. Die Methode verbindet öffentlich berichtete Vorhaben, Organisationsinterviews und Führungskräftebefragungen auf Konferenzen. Der Bericht nennt unterschiedliche Teilstichproben und Erfolgsdefinitionen. Die Zahl ist keine repräsentative Vollerhebung sämtlicher KI-Projekte.[4]
Der NANDA-Bericht definiert erfolgreiche aufgabenspezifische Einführung außerdem über von Nutzern oder Führungskräften berichtete anhaltende Produktivitäts- oder finanzielle Wirkung. Das unterscheidet sich vom bloßen Start in einem Live-System. Bewahren Sie die Abgrenzung bei einer Weitergabe als technische Fehlerquote auf.[4]
Gartners Mitteilung vom September 2026 liefert einen neueren Skalierungsbefund: 22 % der Organisationen skalieren KI erfolgreich über mehrere Geschäftseinheiten oder verfolgen einen KI-zuerst-Ansatz. Befragt wurden 1.303 Personen aus Organisationen mit mindestens 50 Millionen US-Dollar Jahresumsatz. Der Rest ist nicht automatisch eine Gruppe gescheiterter Projekte.[1]
Gartners Prognose vom Februar 2025 ist enger: Bis einschließlich 2026 erwartet der Herausgeber 60 % Abbruch bei Projekten ohne KI-geeignete Daten. Das ist eine bedingte Prognose für eine gefährdete Gruppe, keine beobachtete Fehlerquote sämtlicher Einführungen.[5]
Warum stocken KI-Piloten vor dem Betrieb?
Ein Pilot kann stocken, weil Aufgabe, Daten oder Betriebsbedingungen ungeklärt sind. RAND befragte für seine Forschung vom August 2024 insgesamt 65 erfahrene Praktiker und identifizierte Probleme bei Geschäftsverständnis, Daten, Technologiewahl, Infrastruktur und KI-Fähigkeitsgrenzen. Diese Fragen können nach dem Start fortbestehen.[2]
Unklare Erfolgskriterien. Prüft ein Team nur plausibel wirkende Antworten, kann die korrekte Erledigung der Kundenaufgabe fehlen. Definieren Sie die zu entscheidende Frage. Ein sinnvolles Ergebnis kann die Fortsetzung, ein engerer Umfang oder die Beibehaltung menschlicher Bearbeitung sein.
Eine Stichprobe ohne reale Arbeit. Beziehen Sie ungewöhnliche Eingaben, fehlende Informationen und Übergabefälle ein. Eine saubere Demonstration erklärt eine Funktion; ein betrieblicher Versuch sollte auch Stopp- und Übergabebedingungen zeigen. Der Wechsel in den Betrieb beseitigt die Datenfragen nicht.
Kein Übergangsplan. Wer liefert Live-Informationen, genehmigt Handlungen, empfängt Fehler und pflegt Verbindungen? Klären Sie das vor der Abhängigkeit des Versuchs davon. Ein Versuch kann bewusst begrenzt sein und dennoch spätere Startbedingungen prüfen.
RAND warnt außerdem vor neuester Technik statt passender Lösung und Aufgaben jenseits technischer Fähigkeiten. Klare Verantwortung macht weder ein ungeeignetes Modell noch fehlende Daten ausreichend. Prüfen Sie Machbarkeit zusammen mit dem Prozess statt erst nach dem Kauf.[2]
Wie unterscheiden sich Pilot-Fehlerursachen von Produktions-Fehlerursachen?
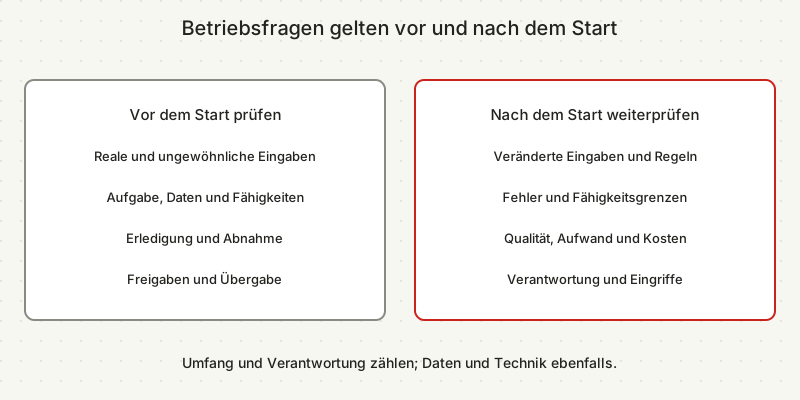
Pilot- und Betriebsrisiken überschneiden sich. Untersuchen Sie im Versuch dieselben Daten, Entscheidungen und Übergaben wie im späteren Ablauf und prüfen Sie nach dem Start weiter. Die Tabelle ist eine praktische Planungshilfe, keine gemessene Verteilung von Fehlerursachen.
| Risiko | Prüfung im Pilot | Laufende Prüfung im Betrieb | Praktische Antwort |
|---|---|---|---|
| Keine Erfolgskriterien | Erfüllung eines schriftlichen Aufgabenergebnisses | Qualität und Erledigung daran messen | Abnahme vor Live-Handlungen definieren |
| Begrenzte oder bereinigte Eingaben | Fehlende, ungewöhnliche und strittige Fälle | Veränderungen realer Eingänge | Repräsentative Beispiele und Ausnahmewege behalten |
| Kein Übergangsplan | Live-Daten, Freigaben und Zuständigkeiten | Funktion der Übergabe | Betriebsmodell vor dem Start vereinbaren |
| Unklarer Prozessumfang | Erlaubtes Lesen, Vorbereiten und Ändern | Anfragen außerhalb der Grenze | Handlungen und Eskalation dokumentieren |
| Keine Wartungsverantwortung | Empfänger von Fehlern und Änderungsbefugnisse | Erledigung und Dokumentation von Problemen | Verantwortliche Person mit Rechten und Zeit benennen |
| Veränderte Verbindungen | Fehlender oder veränderter Datenzugang | Werkzeuge, Rechte und Felder | Nach relevanten Änderungen prüfen |
| Veränderte Anweisungen | Antworten unter aktueller Regel | Veralteter Wortlaut oder Regeln | Bei Regel- oder Ergebnisänderungen prüfen |
| Unzureichende Daten oder Infrastruktur | Ausführbarkeit mit vorhandenen Eingaben | Zuverlässigkeit und Verfügbarkeit | Abhängigkeit vor Erweiterung lösen |
| Fähigkeitsgrenze | Nicht zuverlässig lösbare Aufgaben | Neue Fälle außerhalb geprüfter Fähigkeit | Umfang verengen oder Menschen einsetzen |
Ein Häkchen garantiert keinen Erfolg. Sie brauchen tatsächliche Ergebnisse bei repräsentativer Arbeit und einen funktionierenden Ausnahmeweg. Halten Sie technische und organisatorische Fragen zusammen.
Welche Fehlerfragen bleiben nach dem Start wichtig?
Umfang und Verantwortung bleiben sinnvoll zu definieren, erklären Betriebsfehler aber nicht vollständig. Gartners Prognose vom Juni 2025 erwartet bis Ende 2027 den Abbruch von über 40 % agentischer KI-Projekte wegen steigender Kosten, unklaren Geschäftsnutzens oder unzureichender Risikokontrollen.[3] Unsere Agentic-AI-Statistiken sammeln die Zahlen zu Einführung und Ertrag 2026, neben denen diese Prognose steht.
Prozessumfang. Beschreiben Sie den Umgang mit unvollständigem Datensatz, ungewöhnlicher Anfrage und unerlaubter Handlung. Angenommen, ein Kunde verlangt ohne passende Bestellung eine Erstattung: Der Ablauf braucht einen Weg zu einer Person statt erfundener Nachweise. Das ist ein vorgeschlagenes Beispiel, kein berichteter Kundenfall.
Aktualisieren Sie die Beschreibung bei geänderten Regeln oder Werkzeugen. Die laufende Arbeit erklärt KI-Agenten-Wartung. Ein bestandener Erstversuch wird zum Vergleichsmaßstab späterer Prüfungen, nicht zum Grund, die Kontrolle einzustellen.
Betriebsverantwortung. Wer empfängt Warnungen, stoppt Handlungen und genehmigt Korrekturen? Diese Person braucht Aufzeichnungen und einen Weg zur technischen Unterstützung. Bemessen Sie den Prüfaufwand nach Volumen, Folgen und beobachteten Fehlern statt einer immer ausreichenden kleinen Monatspauschale.
Kosten und Fähigkeit zählen zusätzlich zur Zuständigkeit. Erfüllt das System die Abnahme nicht, verengen Sie die Aufgabe oder stoppen Sie die betroffene Handlung während der Untersuchung. Auch ein betreutes Projekt kann ungeeignet oder unwirtschaftlich sein.
Ein Pilot sollte die später benötigten Betriebsbedingungen einschließlich Grenzen und Übergabe prüfen.
Was definieren fehlerresistente Implementierungen vor dem Start?
Definieren Sie Aufgabe, Abnahmeentscheidung und Betriebsverantwortung vor Live-Befugnissen. Das sind praktische Vorbereitungsschritte, keine Zusage vollständiger Risikovermeidung oder eines für jede Aufgabe passenden Prüfkalenders.
Den Workflow als Prozessdokument aufschreiben
Erfolgskriterien vor dem Versuch definieren
Betriebsverantwortung vor dem Start benennen
Eine Prozessbeschreibung. Beschreiben Sie statt „Nachfassen automatisieren“ einen vorgeschlagenen Fall: Eine neue Anfrage trifft ein, der Agent findet den Kundendatensatz, bereitet eine erlaubte Antwort vor und legt sie zur Freigabe vor. Was passiert bei fehlendem Datensatz oder Streit? Wie Sie einen KI-Agenten briefen behandelt den vollständigen Auftrag.
Eine definierte Prüfentscheidung. Sie könnten nach 30 und nach 90 Tagen prüfen, wenn diese Zeiträume repräsentative Arbeit abdecken. Das sind beispielhafte Prüfpunkte, keine wissenschaftlich belegten Zuverlässigkeitsschwellen. Bestimmen Sie Ergebnisse für Fortsetzung, Eingrenzung oder Stopp.
Eine benannte Verantwortung. Machen Sie Zuständigkeit nutzbar: Wer vertritt Abwesenheit, welche Vorfälle stoppen Handlungen, wo werden Fehler erfasst und wer stimmt geänderten Regeln zu? Ein Name im Dokument ist der Anfang. Der Ablauf braucht eine bei verletzten Bedingungen handlungsfähige Person.
Was sagen die Daten über Post-Go-Live-Fehler?
Eine Produktionsübergangsquote zeigt den erreichten Start, nicht die Dauer zuverlässigen Betriebs danach. Lenovos Mitteilung vom Januar 2026 zur beauftragten IDC-Forschung nennt 46 % in den Betrieb übergegangene KI-Machbarkeitsversuche bei 3.120 IT- und Geschäftsentscheidern. Das ergibt keine allgemeine Überlebenskurve nach dem Start.[7]
Die Forschung stammt aus September–Oktober 2025 und mehreren Weltregionen. Ihr Betriebsmaß unterscheidet sich von Gartners betrieblicher Skalierung und NANDAs Wirkungsdefinition. Lesen Sie jede Untersuchung einzeln statt Prozentveränderungen als unmittelbar gemessenen Branchentrend.[7]
| Zu beobachtende Phase | Betriebliche Aufzeichnungen | Unterstützte Entscheidung |
|---|---|---|
| Vor dem Start | Repräsentative Fälle, fehlende Daten, Rechte, Abnahmeergebnis | Fortsetzen, verengen oder stoppen |
| Früher Live-Betrieb | Erledigte Arbeit, Fehler, Übergaben und Prüfaufwand | Funktioniert der anfängliche Umfang? |
| Nach Regel- oder Werkzeugänderung | Wiederholte Abnahme und veränderte Fehlermuster | Können Handlungen weiterlaufen? |
| Laufender Betrieb | Kosten, nützliche Ergebnisse, Vorfälle und offene Ausnahmen | Pflegen, ändern oder beenden |
Das ist ein Beobachtungsplan, keine geschätzte Phasenquote. Halten Sie technische Fehler, abgelehnte Versuche und schwache finanzielle Ergebnisse getrennt. So entsteht eine bessere Entscheidungsbasis als durch Anwendung einer Marktschlagzeile auf jeden Vorfall.
Ein Stopp kann verantwortlich sein, wenn die Aufgabe zu akzeptablen Kosten nicht angemessen lösbar ist. Dokumentieren Sie den Grund, bewahren Sie Belege auf und geben Sie die Arbeit an Menschen zurück. Ziel ist ein nützlicher Betriebsprozess, keine für die Erfolgszählung künstlich erhaltene Einführung.
Häufig gestellte Fragen
Wie hoch ist die Fehlerquote bei KI-Projekten 2026? Es gibt keine einheitliche vergleichbare Rate. S&P Globals Befragung 2025 nennt 42 % der Unternehmen mit Abbruch der meisten Vorhaben vor dem Betrieb; Gartner misst 2026 betriebliche Skalierung. Beendeter Pilot, technischer Fehler und fehlender finanzieller Ertrag sind getrennte Ergebnisse. Bewahren Sie Gruppe und Definition auf.[1][6]
Warum scheitern die meisten KI-Piloten? Ein Pilot stockt bei unklarer Aufgabe, Erfolgskriterien, Datenlage oder Übergabeverantwortung. RANDs Praktikerforschung nennt zudem ungeeignete Technologiewahl, Infrastrukturlücken und Aufgaben jenseits der KI-Fähigkeit. Diese Risiken betreffen nicht ausschließlich Piloten.[2]
Was lässt Live-KI-Implementierungen scheitern? Umfang und Verantwortung zählen neben Datenqualität, Systemfähigkeit, Betriebskosten und Risikokontrollen. Gartners Abbruchwert von über 40 % ist eine Prognose für Ende 2027, keine beobachtete Quote allein wegen fehlender Wartungsverantwortung.[2][3]
Wie reduziere ich das Risiko, dass eine KI-Implementierung scheitert? Definieren Sie erlaubte Arbeit, repräsentative Prüfungen, Abnahme und eine für Fehler handlungsfähige Person. Wählen Sie Prüfungen nach Aufgabenzyklen und Änderungen. Behalten Sie Eingrenzung und Stopp bei unzureichender Qualität oder unpassenden Kosten als Entscheidungsmöglichkeiten.
Quellen
- Gartner Survey Finds Only 22% of Organizations Have Successfully Scaled AI Across Multiple Business Units. 1. September 2026; Erhebung Januar–April 2026 Abgerufen am 15. Oktober 2026.
- The Root Causes of Failure for Artificial Intelligence Projects and How They Can Succeed. 13. August 2024 Abgerufen am 15. Oktober 2026.
- Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. 25. Juni 2025 Abgerufen am 15. Oktober 2026.
- The GenAI Divide: State of AI in Business 2025 — preliminary report. Juli 2025; Forschungszeitraum Januar–Juni 2025; Originalbericht, Kopie bei AI News Abgerufen am 15. Oktober 2026.
- Lack of AI-Ready Data Puts AI Projects at Risk. 26. Februar 2025; Datenerhebung Juli 2024 Abgerufen am 15. Oktober 2026.
- Generative AI experiences rapid adoption, but with mixed outcomes — Highlights from VotE: AI & Machine Learning. 30. Mai 2025 Abgerufen am 15. Oktober 2026.
- Research From Lenovo Reveals AI Is Paying Off, Yet Most CIOs Aren’t Ready for What Comes Next. 27. Januar 2026; Erhebung 16. September–17. Oktober 2025 Abgerufen am 15. Oktober 2026.