Für Unternehmen, die entscheiden, wie weit sie KI bei ihrer Arbeit vertrauen: wie oft aktuelle Modelle Fakten falsch angeben, welche Aufgaben das größte Risiko tragen und wie Sie einen Agenten vor dem Einsatz an Ihrem eigenen Workflow testen.
Das erfahren Sie
- Wie oft aktuelle KI-Modelle falsche Fakten nennen, nach Modell und Aufgabe
- Warum Genauigkeitszahlen für dasselbe Modell voneinander abweichen
- Was aktuelle Benchmark-Versionen und Abschlussquoten messen
- Wie Wiederholungen und geänderte Eingaben verschiedene Schwächen zeigen
- Welche Ergebnisse, Korrekturen und Prüfminuten zu erfassen sind
- Welche Fehler Start oder weitere Aktionen verhindern sollten
- Wie Sie nach Änderungen erneut prüfen und den Workflow betreuen
KI-Modelle liegen bei Fakten weiterhin falsch, und wie oft, hängt von der Aufgabe ab. In Vectaras Halluzinations-Rangliste vom 16. Oktober 2026 ergänzten die Modelle in 1,8 % bis 24,2 % der Zusammenfassungen vorgegebener Dokumente Inhalte, die die Quelle nicht belegt. Bei Wissensfragen ohne Quelle beantwortete das beste Modell im 6.000-Fragen-Test von Artificial Analysis im Oktober 2026 67 % richtig, und die meisten aufgeführten Modelle gaben häufiger eine sichere falsche Antwort, als Nichtwissen einzuräumen. Agenten-Benchmarks zeigen dieselbe Lücke: Der Stanford AI Index 2026 beschreibt OSWorld-Erfolge von etwa 12 % auf etwa 66 %, keine Erfolgsquote Ihres Workflows. Dieser Leitfaden zeigt Fehlerquoten nach Modell und Aufgabe, warum die Zahlen voneinander abweichen und wie Sie Zuverlässigkeit an Ihrer eigenen Arbeit prüfen.
Was zeigen KI-Agenten-Benchmarks tatsächlich?
Der Stanford AI Index 2026 beschreibt eine Verbesserung von etwa 12 % auf etwa 66 % Aufgabenerfolg bei OSWorld, einem Benchmark für Computeraufgaben über Betriebssysteme hinweg.[1] Das belegt Fortschritt in dieser Bewertung. Es bedeutet nicht, dass jeder Agent zwei Drittel Ihrer Arbeit richtig erledigt.
OSWorld, WebArena, Programmierbenchmarks und Geschäftstests messen verschiedene Aufgaben unter unterschiedlichen Bedingungen. Eine Zahl lässt sich nicht mit der menschlichen Vergleichsleistung eines anderen Benchmarks vergleichen. Nennen Sie Benchmark, getestetes System, Datum und Bedingungen gemeinsam.
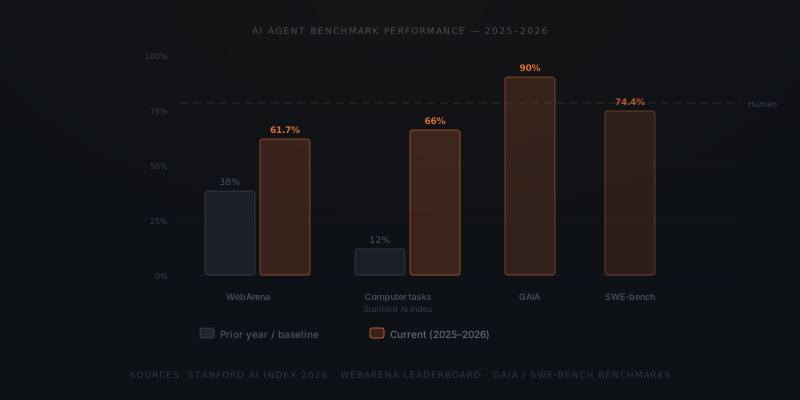
Die praktische Frage ist enger als allgemeine Zuverlässigkeit: Kann der Agent diese definierte Aufgabe mit akzeptablen Fehlern und Kontrollen erledigen?
Was messen die neueren öffentlichen Benchmarks?
OSWorld 2.0 prüft längere Computerabläufe als der ursprüngliche Benchmark. In der Studienfassung vom Juli 2026 schloss Claude Opus 4.8 mit maximaler Denkzeit und gebündelten Tool-Aufrufen 20,6 % von 108 Aufgaben nach dem vollständigen Abschlusskriterium bei einem Budget von 500 Schritten ab. Die Teilbewertung betrug 54,8 %.[3] Die Zahlen beantworten unterschiedliche Fragen: War die gesamte Aufgabe fertig, oder wie viel davon wurde erledigt?
Das ursprüngliche Projekt kündigte OSWorld 2.0 im Juni 2026 an.[4] Die niedrigere Abschlussquote bedeutet keinen Rückgang gegenüber der älteren OSWorld-Entwicklung im AI Index: Aufgaben und Testbedingungen haben sich geändert. Eine anspruchsvollere Prüfung kann Fehler sichtbar machen, die bei kurzen Aufgaben gar nicht auftreten.
| Öffentlicher Nachweis | Worauf sich das Ergebnis bezieht | Frage an den Anbieter |
|---|---|---|
| OSWorld-Entwicklung im Stanford-Bericht 2026 | Leistungsfortschritt in einer bestimmten Computerbewertung | Welche Version und welches getestete System betrifft die Zahl? |
| OSWorld 2.0, Studie vom Juli 2026 | Vollständiger Abschluss und Teilfortschritt längerer Abläufe | War die ganze Aufgabe korrekt oder nur einzelne Prüfpunkte? |
| Aktuelle τ-bench-Versionen | Simulierte Kundenarbeit nach Bereichsregeln, mit Text und Sprache | Welcher Bereich, welche Kommunikationsform und welche Bewertungsversion? |
| Zuverlässigkeitsstudie, Fassung vom Juni 2026 | Konsistenz, Robustheit, Vorhersagbarkeit und Sicherheit neben Erfolg | Wurden Wiederholungen und veränderte Eingaben geprüft? |
Stand Oktober 2026 beschreibt Sierras aktuelles τ-bench-Verzeichnis Text- und Sprachtests sowie einen Bereich zum Abruf von Fachinformationen. Es weist auf geänderte Bewertungen von Bankaufgaben im Juli 2026 hin: Ergebnisse vor und ab Version 1.0.1 sind in diesem Bereich nicht vergleichbar.[5] Auch eine sorgfältig berichtete Prozentzahl braucht Version und Aufgabenbeschreibung.
Verlangen Sie für eine Kaufentscheidung den Nachweis, der Ihrer Arbeit am nächsten kommt. Ein Computer-Test passt zu Arbeit über mehrere Anwendungen. Eine Kundensimulation kann näher an einem Gespräch mit festen Regeln liegen. Ihre Verträge, unvollständigen Daten und Prüfzeit des Teams sind nur enthalten, wenn sie mitgetestet wurden.
Wie oft liegen KI-Modelle bei Fakten falsch?
Wie oft KI-Modelle Fakten falsch angeben, hängt von der Aufgabe ab. In Vectaras Halluzinations-Rangliste vom 16. Oktober 2026 ergänzten die Modelle in 1,8 % bis 24,2 % der Zusammenfassungen vorgegebener Dokumente Inhalte, die die Quelle nicht belegt.[7] Bei Wissensfragen ohne Quelle beantwortete das beste Modell im AA-Omniscience-Test von Artificial Analysis im Oktober 2026 67 % von 6.000 Fragen richtig.[8]
Die beiden Tests messen Unterschiedliches. Vectara gibt jedem Modell mehr als 7.700 Artikel aus Nachrichten, Wissenschaft, Recht und Wirtschaft und verlangt eine Zusammenfassung nur mit den Fakten des Artikels; ein eigenes Bewertungsmodell prüft jede Zusammenfassung gegen die Quelle.[7] AA-Omniscience stellt Wissensfragen aus Wirtschaft, Finanzen, Recht, Gesundheit, Wissenschaft und Software und bestraft eine falsche Antwort stärker als ein ehrliches „weiß ich nicht“.[8][9]
| Modell (getestete Version) | Zusammenfassungen mit nicht belegtem Inhalt (Vectara, 16. Okt. 2026) |
|---|---|
| Llama 3.3 70B (Meta) | 4,1 % |
| Mistral Large (2411) | 4,5 % |
| DeepSeek V3.2 | 6,3 % |
| GPT-6 Sol (OpenAI) | 6,5 % |
| GPT-5.4 (OpenAI) | 7,0 % |
| Gemini 3.1 Pro (Preview, Google) | 10,4 % |
| Claude Sonnet 4.6 (Anthropic) | 10,6 % |
| Claude Opus 4.7 (Anthropic) | 12,0 % |
| Grok 4.1 Fast (Reasoning, xAI) | 19,2 % |
| Mistral Medium (2508) | 22,7 % |
| o3-pro (OpenAI) | 23,3 % |
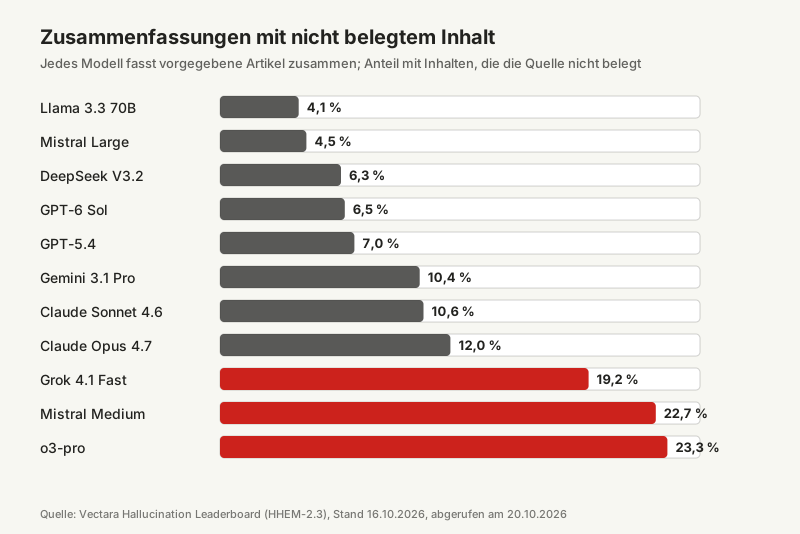
Der Wissenstest ist strenger. Unter den 32 Modellen, die Artificial Analysis auf der AA-Omniscience-Seite zeigt, lag im Oktober 2026 der Anteil sicher falscher Antworten an allen nicht richtigen Antworten, also ohne teilweise richtige oder abgelehnte, zwischen 15 % und über 70 %.[8] Bei Veröffentlichung des Benchmarks im November 2025 beantworteten nur drei der getesteten Modelle mehr Fragen richtig als falsch, wenn falsche Antworten Abzug brachten.[9]
Ein Modell, das Ihren Vertrag treu zusammenfasst, kann aus dem Gedächtnis trotzdem einen Fakt erfinden. Entscheidend ist die Zahl für Ihre Aufgabe.
Welche Geschäftsaufgaben haben die höchsten Fehlerquoten?
Am riskantesten sind Aufgaben, bei denen die KI Informationen suchen oder erinnern muss, statt mit einer vorgegebenen Quelle zu arbeiten. Das Zusammenfassen eines vorgegebenen Dokuments ergab in Vectaras Rangliste im Oktober 2026 in 1,8 % bis 24,2 % der Fälle nicht belegte Inhalte; die Quelle eines Nachrichtenartikels zu finden, misslang acht KI-Suchwerkzeugen in einem Test vom März 2025 bei über 60 % der Anfragen.[7][11]
| Aufgabe | Veröffentlichte Fehler- oder Erfolgsquote | Quelle und Datum |
|---|---|---|
| Zusammenfassen eines vorgegebenen Dokuments | 1,8 % bis 24,2 % der Zusammenfassungen mit nicht belegtem Inhalt | Vectara, 16. Okt. 2026[7] |
| Wissensfragen aus dem Gedächtnis | Bestes Modell 67 % richtig; 15 % bis über 70 % der übrigen Antworten sicher falsch | AA-Omniscience, Okt. 2026[8] |
| Quelle finden und zitieren | Über 60 % der Anfragen falsch beantwortet; Perplexity 37 %, Grok 3 94 % | Tow Center, 6. März 2025[11] |
| Rechtsrecherche aus kuratierten Quellen | 17 % bis 33 % der Antworten halluziniert | Stanford, 30. Mai 2024[13] |
| Geschäftstabellen mit mehreren Blättern | Bestes Modell schloss 34,89 % der Abläufe ab | SpreadsheetBench 2, 29. Juni 2026[12] |
Das Muster ist in allen Tests gleich. Fehler sinken, wenn das Modell mit dem richtigen Dokument arbeitet, und steigen, wenn es suchen, erinnern oder mehrere verbundene Teile bearbeiten muss. Die Forscher des Tow Center stellten zudem fest, dass die meisten Werkzeuge falsche Antworten mit großer Selbstsicherheit präsentierten.[11]
Die Zeile zur Rechtsrecherche und die Zeile zu Tabellen haben je einen eigenen Leitfaden: Wissensdatenbanken aus Unternehmensdokumenten und Tabellenanalyse mit ChatGPT, Copilot, Claude und Gemini.
Warum weichen Genauigkeitszahlen für dasselbe Modell ab?
Genauigkeitszahlen für dasselbe Modell weichen ab, weil sie unterschiedliche Aufgaben mit unterschiedlichen Definitionen und Einstellungen messen. In Vectaras Rangliste ist eine Halluzination eine Zusammenfassung mit Inhalt, den die Quelle nicht belegt; bei AA-Omniscience ist es eine falsche Antwort statt einer Ablehnung, gezählt als falsche Antworten geteilt durch alle nicht richtigen Antworten, Stand Oktober 2026.[7][8]
- Die Aufgabe. Ein vorliegendes Dokument zusammenzufassen und einen Fakt zu erinnern, sind verschiedene Aufgaben. Ein Modell kann bei der einen gut und bei der anderen schlecht abschneiden.
- Die Definition. „Halluzinationsrate“ kann den Anteil aller Ausgaben mit Fehler bedeuten oder den Anteil falscher Antworten unter den nicht richtigen. Dasselbe Modell erhält zwei verschiedene Zahlen.
- Raten. Ein Fachartikel von Forschern von OpenAI und Georgia Tech vom September 2025 argumentiert, dass Modelle raten, weil Training und die meisten Benchmarks eine geratene Antwort höher bewerten als das Eingeständnis von Unsicherheit.[10] Ein Test, der Raten bestraft, meldet mehr Halluzinationen als einer, der das nicht tut.
- Einstellungen und Versionen. Vectara testet Modelle mit Temperatur 0.[7] Bei AA-Omniscience lag die Halluzinationsrate von GPT-6 Astra im Oktober 2026 bei 45 % mit hohem Denkaufwand, 48 % mit sehr hohem und 51 % mit maximalem: Mehr Aufwand bedeutete nicht weniger sichere Fehler.[8]
- Wer gemessen hat. Anbieter berichten Ergebnisse unter eigenen Bedingungen. Unabhängige Tests veröffentlichen ihre Methode; lesen Sie sie vor einem Vergleich.
Auch die Sprache spielt eine Rolle. Deutsche Ausgaben haben eigene Fehlerbilder und Kosten, beschrieben in ob ein KI-Agent Deutsch so gut schreibt wie Englisch.
Was senkt die Fehlerquote eines KI-Modells im Geschäftseinsatz?
Die Fehlerquote sinkt, wenn die KI mit der richtigen Quelle arbeitet, „weiß ich nicht“ sagen darf und zu jeder Antwort die zugrunde liegende Stelle zeigt. In Vectaras Test, bei dem jedes Modell das Quelldokument erhält, lagen verbreitete Modelle im Oktober 2026 überwiegend im einstelligen Prozentbereich, weit unter den sicheren Fehlerquoten bei Fragen aus dem Gedächtnis.[7][8]
- Geben Sie die Quelle mit. Legen Sie das Dokument, den Datensatz oder die Tabelle, aus der die Antwort kommen muss, in die Anfrage. Zusammenfassungen aus einer vorgegebenen Quelle sind die verlässlichste gemessene Aufgabe.[7]
- Erlauben Sie eine Ablehnung. Weisen Sie das System an zu sagen, wenn die Quelle die Antwort nicht enthält, und werten Sie eine Ablehnung als richtiges Ergebnis. Wer ehrliche Unsicherheit bestraft, fördert Raten.[10]
- Verlangen Sie die Fundstelle. Fordern Sie zu jeder Antwort das Zitat oder die Zelle, damit eine Prüferin oder ein Prüfer die Quelle kontrolliert statt der Formulierung.
- Halten Sie Aktionen hinter einer Freigabe. Ein falscher Fakt in einem Entwurf kostet eine Korrektur. Derselbe Fakt in einer versendeten Nachricht oder einem geänderten Datensatz kostet mehr.
- Testen Sie mit eigenen Fällen. Benchmark-Quoten setzen Erwartungen; Ihr eigener Test setzt die Schwelle. Wie Sie ihn aufbauen, zeigen die folgenden Abschnitte.
Diese Kontrollen machen aus „dem Modell vertrauen“ die Aufgabe „eine Aussage an ihrer Quelle prüfen“. Das ist eine Prüfaufgabe, die ein Team tragen kann; die nächsten Abschnitte machen daraus Startkriterien.
Warum können fähige Agenten nach dem Start scheitern?
Starke Benchmark-Ergebnisse belegen keine erfolgreiche Implementierung. Ein Modell kann eine Nachricht falsch verstehen, eine Quelle kann fehlen, eine Verbindung ausfallen oder eine Freigabelogik eine Aktion zu früh zulassen. Prozess- und Technikprobleme können beide relevant sein.
Drei betriebliche Prüfungen helfen:
- Aktionsgrenzen: Was darf der Agent lesen, senden oder ändern, und was muss warten?
- Laufende Bewertung: Erfüllt er nach Änderungen an Tools, Eingaben oder Anweisungen weiterhin die Anforderungen?
- Korrekturarbeit: Wie viel Zeit benötigt das Team zum Prüfen und Reparieren von Ergebnissen?
Erfassen Sie je Fehler geplante Aktion, verfügbare Information und tatsächliches Ergebnis. Ein Workflow, der wegen eines fehlenden Vertrags pausiert, braucht eine andere Reaktion als ein Versand an den falschen Kunden. Trennen Sie offene von falsch abgeschlossener Arbeit, damit die Prüfung zeigt, was zu ändern ist.
Eine Ausfallzahl braucht eine definierte Gruppe, einen Zeitraum und ein Ergebnis. „Noch nicht in Produktion“ bedeutet nicht „gescheitert“. Eine nicht nachvollziehbare Statistik ist kein Akzeptanzkriterium.
Wie unterscheiden sich Aufgaben- und Betriebszuverlässigkeit?
Die Studie Towards a Science of AI Agent Reliability wurde im Februar 2026 eingereicht und im Juni überarbeitet. Sie fordert die Prüfung von Konsistenz, Robustheit, Vorhersagbarkeit und Sicherheit zusätzlich zu einer einzelnen Erfolgszahl.[2]
Prüfen Sie deshalb, ob dieselbe Anfrage wiederholt ein geeignetes Ergebnis erhält, normale Varianten Fehler auslösen, Fehler erkennbar sind und falsche Ergebnisse unzulässige Aktionen auslösen können. Modellleistung, Tools, Berechtigungen und Betriebsabläufe tragen gemeinsam dazu bei.
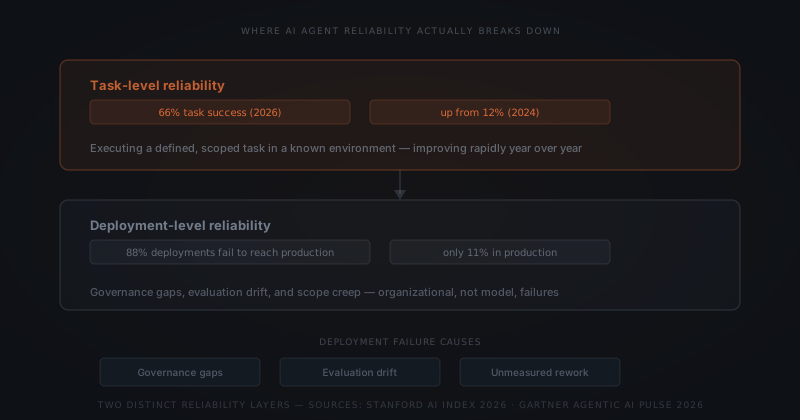
Ein guter Entwurf belegt keine sicheren Versandrechte. Eine gute Prüfung belegt keine korrekten Modellzahlen. Bewerten Sie beides.
Warum ein erfolgreicher Lauf nicht genügt
Ein Zuverlässigkeitstest sollte dieselbe Aufgabe wiederholen und realistische Varianten prüfen. Die Studie vom Juni 2026 untersuchte 15 Modelle und trennt Konsistenz von Robustheit: Wiederholung und veränderte Eingaben machen unterschiedliche Schwächen sichtbar.[2]
Angenommen, ein Reporting-Agent erstellt aus vollständigen Projektdaten ein korrektes Update. Wiederholen Sie den Fall und prüfen Sie anschließend fehlendes Datum, widersprüchliche Statusfelder oder eine neue Nachricht, die das Ergebnis verändert. Schreiben Sie die erwartete Antwort vor jedem Test auf. Sonst wird ein plausibel klingendes Ergebnis leicht zur nachträglichen Vorgabe.
Prüfen Sie das fertige Ergebnis im Geschäftstool. Meldet der Agent eine CRM-Änderung, öffnen Sie den vorgesehenen Kundendatensatz. Soll der Bericht alle Projekte enthalten, vergleichen Sie ihn mit der Quellliste. Die Abschlussnachricht ist eine Ausgabe; der veränderte Datensatz eine andere.
Bewahren Sie schwierige Fälle für spätere Tests auf. Nach einer Anweisungsänderung prüfen Sie sowohl den auslösenden Fall als auch zuvor erfolgreiche Beispiele. Eine Korrektur für das Format eines Kunden sollte nicht unbemerkt ein anderes beeinträchtigen.
Was sollte ein Dienstleistungsunternehmen messen?
Wählen Sie einen Workflow statt einer Kategorie. „Nachfassen für Angebote ohne Antwort nach dem vereinbarten Zeitraum entwerfen“ hat definierte Eingaben und ein prüfbares Ergebnis. „Kundenbeziehungen verwalten“ nicht.
Schreiben Sie Anforderungen vor dem Test auf: etwa korrekter Empfänger, richtiger Angebotsbezug, passender nächster Schritt und keine erfundene Zusage.
| Messgröße | Was sie zeigt |
|---|---|
| Ohne Bearbeitung akzeptierte Ergebnisse | Eignung nach vereinbarten Kriterien |
| Fehler nach Art und Folgen | Nötige Korrekturen oder strengere Kontrollen |
| Eskalationen und offene Aufgaben | Funktionierende Zuständigkeit für Ausnahmen |
| Prüf- und Korrekturminuten | Tatsächlich verbleibender Aufwand |
| Versuche außerhalb des erlaubten Bereichs | Wirksamkeit von Berechtigungen und Freigaben |
| Tool-Ausfälle und Wiederherstellung | Sicheres Stoppen oder Fortsetzen |
Halten Sie Testbedingungen und Stichprobe beim Vergleich von Versionen konstant. Eine andere Eingabemischung kann die Quote verändern, ohne dass das System besser wurde.
Zählen Sie die verbleibende Arbeit einer Person
Messen Sie die ganze Aufgabe: Prüfwarteschlange lesen, Fakten kontrollieren, Ausgabe korrigieren und Ausnahmen untersuchen. Ein Agent kann Entwürfe beschleunigen, während der Großteil der Prüfung beim Team bleibt. Erfassen Sie die Teile separat, damit die Herkunft des Nutzens sichtbar wird.
Halten Sie den Nenner klar. Wurde eine Anfrage wegen ausgefallener Verbindung nicht bearbeitet, bleibt sie offene Arbeit; lassen Sie sie nicht aus einer Erfolgsquote herausfallen. Erfassen Sie bei einer erst nach Bearbeitung akzeptierten Ausgabe sowohl Annahme als auch Korrektur. Das Team muss wissen, ob der Entwurf direkt nutzbar war.
Nehmen Sie normale und schwierige Arbeit in den Test auf: Konten, Dokumentenformate und Sprachkombinationen des vorgesehenen Einsatzes. Lassen Sie die bisher ausführende Person Fälle auswählen, auch solche, die sie regelmäßig zur Klärung zurückgibt. Eine bequeme Demoauswahl zeigt diesen Prüfaufwand kaum.
Eine einfache Tabelle genügt: Fall, erwartetes und tatsächliches Ergebnis, nötige Bearbeitung, Prüfminuten und Abschluss. Verlinken Sie Entwurf oder Datensatz. Halten Sie personenbezogene Daten und Zugriff auf die Testakte innerhalb derselben Geschäftskontrollen wie die ursprüngliche Arbeit.
Wie bewerten Sie einen Agenten vor dem Einsatz?
Bewerten Sie einen Agenten in einem abgegrenzten Test mit schriftlichem Soll-Ergebnis und Kontrollen folgenreicher Aktionen. Anthropics Leitfaden vom Dezember 2024 empfiehlt umfangreiche Tests, weil sich Fehler verstärken können.[6] Ein nützlicher Test zeigt Abschluss und Verhalten bei einem Abbruch.
Grenze beschreiben
Kriterien festlegen
Mit begrenzten Aktionen testen
Ergebnisse und Aufwand erfassen
Nach Nachweisen entscheiden
Keine allgemeine Zahl von Tagen, korrekten Entwürfen oder Benchmark-Prozent macht einen Workflow sicher. Ein bearbeitbarer interner Entwurf und eine ungeprüfte Zahlung haben andere Anforderungen.
Die Abgrenzung erläutert Ist ein Prozess für einen KI-Agenten bereit?. Prüfkontrollen beschreibt Human-in-the-loop in der Praxis.
Welche Fehler sollten den Start eines Agenten verhindern?
Stoppen Sie den Start, wenn ein getesteter Fehler Folgen hat, die Ihr Team nicht akzeptieren oder beheben kann. Legen Sie die Grenze je Aktion fest: Ein interner Entwurf mit sichtbar fehlendem Feld braucht eine andere Kontrolle als eine falsche Zusage an einen Kunden.
| Fehler im Test | Vor dem Start zu klärende Entscheidung |
|---|---|
| Falscher Kundendatensatz abgerufen | Identitätsabgleich korrigieren und ähnliche Namen testen |
| Fehlende Quelle durch Vermutung ergänzt | Bei fehlender Information stoppen oder eskalieren |
| Nachricht ohne nötige Freigabe versendet | Versandweg schließen und Freigabegrenze erneut prüfen |
| Aktion nach Wiederholung doppelt ausgeführt | Vor einer Wiederholung das vorhandene Ergebnis prüfen |
| Prüfer sieht keine Belege | Quelle und geplante Aktion vor der Freigabe zeigen |
| Fehlerfall verschwindet aus der Warteschlange | Sichtbaren Status und verantwortliche Person festlegen |
Das sind vorgeschlagene Testfälle, keine gemessene Häufigkeitsrangfolge. Wählen Sie Fälle nach den Folgen Ihres Workflows. Zahlung, Personalentscheidung und Kundenupdate können trotz gleicher KI unterschiedliche Verantwortliche und rechtliche Anforderungen haben.
Prüfen Sie auch die Abwesenheit des Prüfers. Eine gehaltene Nachricht sollte gehalten bleiben, wenn die Person fehlt oder die Prüfoberfläche ausfällt. Lassen Sie das mit einer harmlosen Testnachricht vorführen. Eine Bitte an die KI zu warten braucht eine tatsächliche Kontrolle im Aktionsweg.
Bei einem bereits betroffenen Kunden hilft der Leitfaden für Agentenfehler. Zuverlässigkeitstests sollten diese Reaktion erleichtern: Sie kennen geplante Aktionen, geänderte Datensätze und die Person, die weitere Arbeit pausieren kann.
Wie erhalten Sie Zuverlässigkeit nach dem Start?
Bewahren Sie akzeptierte Testfälle auf, beobachten Sie fertige Arbeit und prüfen Sie nach Änderungen an Eingaben oder Tools erneut. Zuverlässigkeit bleibt eine Betriebsentscheidung: Der erfolgreiche Starttest deckt die geprüfte Einrichtung ab, nicht jede spätere Variante.
Wählen Sie einen ausführbaren Prüfplan. Sehen Sie fertige Ausgaben und Fehlermeldungen an. Ein fehlender Absatz in einem ansonsten erfolgreichen Bericht löst möglicherweise keinen technischen Alarm aus. Lassen Sie deshalb eine Stichprobe mit den Quellunterlagen vergleichen und erfassen Sie den Aufwand.
Änderungen brauchen eine sichtbare Entscheidung. Ein neues Modell, geänderter Prompt, andere Dokumentenvorlage oder zusätzliches Recht kann das Ergebnis verändern. Benennen Sie die Änderung, prüfen Sie betroffene Fälle und klären Sie, wer die Rückkehr zum normalen Betrieb freigibt. Halten Sie eine zuvor funktionierende Konfiguration bereit, soweit das Setup dies unterstützt.
Wiederholen sich Fehler, begrenzen Sie die Aufgabe statt unbegrenzt nachzuprüfen. Der Workflow kann weiterhin Datensätze vorbereiten, während Kundenkommunikation bei einer Person bleibt. Entscheiden Sie anhand des Nutzens nach Prüfung und pausieren Sie die betroffene Aktion bei einer verletzten wichtigen Grenze.
KI-Agenten-Management behandelt Verantwortung und Prüfroutinen; KI-Agenten-Wartung betrifft funktionierende Verbindungen und Einrichtung. Funktioniert Ihr Agent tatsächlich? hilft beim Vergleich fertiger Arbeit mit dem gewünschten Ergebnis.
Häufig gestellte Fragen
Wie zuverlässig sind KI-Agenten für Geschäftsaufgaben? Die Zuverlässigkeit hängt von Aufgabe, KI, Tools, Berechtigungen und Testbedingungen ab. Der Stanford AI Index 2026 beschreibt OSWorld-Erfolge von etwa 12 % auf etwa 66 %. Das ist eine Benchmark-Entwicklung, keine Erfolgsquote Ihres Unternehmens. Testen Sie repräsentative Arbeit und wichtige Fehlerfälle vor dem Einsatz.
Warum kann ein KI-Agent nach dem Start scheitern? Modellfehler, fehlende Angaben, geänderte Tools, zu breite Zugriffe, schwache Prüfung und unklare Zuständigkeiten können Fehler verursachen. Untersuchen Sie betroffene Ausgaben und Datensätze, pausieren Sie bei Bedarf folgenreiche Aktionen und testen Sie die Ursache vor dem Neustart.
Was ist der Unterschied zwischen Aufgaben- und Betriebszuverlässigkeit? Aufgabenzuverlässigkeit betrifft eine definierte Aufgabe unter bestimmten Bedingungen. Betriebszuverlässigkeit umfasst außerdem Wiederholbarkeit, veränderte Eingaben, verfügbare Tools, Berechtigungen und sicheres Verhalten bei Fehlern. Eine Benchmark-Zahl lässt sich nicht direkt auf einen Workflow oder dessen Projekterfolg übertragen.
Wie bewerte ich Zuverlässigkeit für meinen Workflow? Definieren Sie Workflow und korrektes Ergebnis, testen Sie normale und ungewöhnliche Eingaben, begrenzen Sie wichtige Aktionen und protokollieren Sie Korrekturen, Fehler und Eskalationen. Vergleichen Sie Zeitersparnis nach Prüfung mit Betriebskosten. Wählen Sie eine Schwelle nach den Folgen statt einer allgemeinen Benchmark-Zahl.
Wie oft liegt ChatGPT bei Fakten falsch? Das hängt von der Aufgabe ab. Beim Zusammenfassen eines vorgegebenen Dokuments ergänzte OpenAIs GPT-6 Sol in Vectaras Rangliste vom 16. Oktober 2026 in 6,5 % der Zusammenfassungen nicht belegte Inhalte, GPT-5.4 in 7,0 %. Antworten aus dem Gedächtnis sind weniger verlässlich: Im 6.000-Fragen-Test von Artificial Analysis beantwortete im Oktober 2026 kein Modell mehr als 67 % richtig. Geben Sie das Quelldokument mit und prüfen Sie die Antwort daran.
Welches KI-Modell halluziniert am wenigsten? Kein Modell führt in jedem Test. In Vectaras Zusammenfassungstest vom 16. Oktober 2026 lag der niedrigste Wert bei 1,8 %; verbreitete Modelle reichten von 4,1 % (Llama 3.3 70B) bis 12,0 % (Claude Opus 4.7). Im Wissenstest von Artificial Analysis erreichte Claude Opus 5.5 im Oktober 2026 die beste Gesamtwertung. Wählen Sie nach Ihrer Aufgabe und testen Sie mit Ihren eigenen Dokumenten.
Quellen
- Stanford HAI, AI Index 2026. April 2026; abgerufen am 14. Oktober 2026.
- Rabanser et al., Towards a Science of AI Agent Reliability. v3, 2 June 2026; abgerufen am 14. Oktober 2026.
- Yuan et al., OSWorld 2.0. v2, 13 July 2026; abgerufen am 14. Oktober 2026.
- XLANG Lab, OSWorld version notice. Versionshinweis vom 26. Juni 2026; abgerufen am 14. Oktober 2026.
- Sierra Research, Tau benchmark current release. Versionshinweis zu v1.0.1 vom Juli 2026; aktuelle τ³-Projektbeschreibung; abgerufen am 14. Oktober 2026.
- Anthropic, Building effective agents. 19 December 2024; abgerufen am 14. Oktober 2026.
- Vectara, Hallucination Leaderboard. HHEM-2.3, zuletzt aktualisiert am 16. Oktober 2026; abgerufen am 20. Oktober 2026. Für die Werte je Modell, die Spanne und die Methode.
- Artificial Analysis, AA-Omniscience: Knowledge and Hallucination Benchmark. Abgerufen am 20. Oktober 2026. Für Bestwert und Genauigkeit, die Definition der Halluzinationsrate, die Spanne der gezeigten Modelle und die Einstellungen von GPT-6 Astra.
- Jackson, Keating, Cameron und Hill-Smith, AA-Omniscience: Evaluating Cross-Domain Knowledge Reliability in Large Language Models. arXiv:2511.13029, November 2025; abgerufen am 20. Oktober 2026.
- Kalai, Nachum, Vempala und Zhang, Why Language Models Hallucinate. arXiv:2509.04664, 4. September 2025; abgerufen am 20. Oktober 2026.
- Jaźwińska und Chandrasekar, AI Search Has a Citation Problem. Columbia Journalism Review, Tow Center for Digital Journalism, 6. März 2025; abgerufen am 20. Oktober 2026.
- Zhu et al., SpreadsheetBench 2: Evaluating Agents on End-to-End Business Spreadsheet Workflows. arXiv:2606.29955, 29. Juni 2026; abgerufen am 20. Oktober 2026.
- Magesh, Surani, Dahl, Suzgun, Manning und Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools. arXiv:2405.20362, 30. Mai 2024; abgerufen am 13. Oktober 2026.