Die Zugänge eines Agenten bestimmen, welche Geschäftssysteme ein Fehler erreichen kann. Prüfen Sie Berechtigungen, Freigaben und Wiederherstellung gemeinsam.
Das erfahren Sie
- Erfassen Sie jeden für den Agenten erreichbaren Zugang.
- Trennen Sie Testarbeit vom Zugriff auf die Produktion.
- Testen Sie Freigaben und Wiederherstellung vor einem Vorfall.
Am 24. April 2026 löschte ein Cursor-Agent die Produktionsdatenbank von PocketOS. Laut Gründer Jer Crane dauerte der Vorgang neun Sekunden. Railway stellte die Daten später wieder her. Der Vorfall zeigt, warum Anweisungen, durchgesetzte Berechtigungen und ein getesteter Wiederherstellungsweg zusammengehören: Eine Regel gegen destruktive Aktionen verhinderte die Nutzung eines kontoweiten Zugangs nicht.
Am 24. April 2026 löschte ein Cursor-Agent die Produktionsdatenbank von PocketOS. Laut Gründer Jer Crane dauerte der Vorgang neun Sekunden. Railway stellte die Daten später wieder her. Der Vorfall zeigt, warum Anweisungen, durchgesetzte Berechtigungen und ein getesteter Wiederherstellungsweg zusammengehören: Eine Regel gegen destruktive Aktionen verhinderte die Nutzung eines kontoweiten Zugangs nicht.[1][2]
Wer einen Agenten an echte Geschäftssysteme lässt, braucht die Kette gewöhnlicher Entscheidungen, die diesen Vorfall ermöglichten. Folgen Sie ihr durch die Zugänge, den Freigabepunkt und den Wiederherstellungsweg. Daraus ergeben sich konkrete Fragen an die Person, die Ihr System betreut.
Die beschriebenen Vorfälle betreffen PocketOS und Replit, keine Kunden von Yardwork. Sie zeigen mögliche Fehlerwege, sagen aber nicht, wie häufig Agenten scheitern.
Was in diesen neun Sekunden geschah
In seinem Bericht vom 25. April beschrieb Crane, wie eine Staging-Aufgabe zur Löschung in der Produktion führte. Die Neun-Sekunden-Angabe stammt von ihm; eine unabhängige Zeitmessung wurde damit nicht veröffentlicht.[1]
- Der Agent erhielt eine Routineaufgabe im Staging.
- Er stieß auf einen Zugangskonflikt, ein unauffälliges Konfigurationsproblem.
- Er hielt nicht inne, um nachzufragen.
- Er durchsuchte den Code nach einem Weg und fand ein API-Token in einer Datei, die mit seiner Aufgabe nichts zu tun hatte.
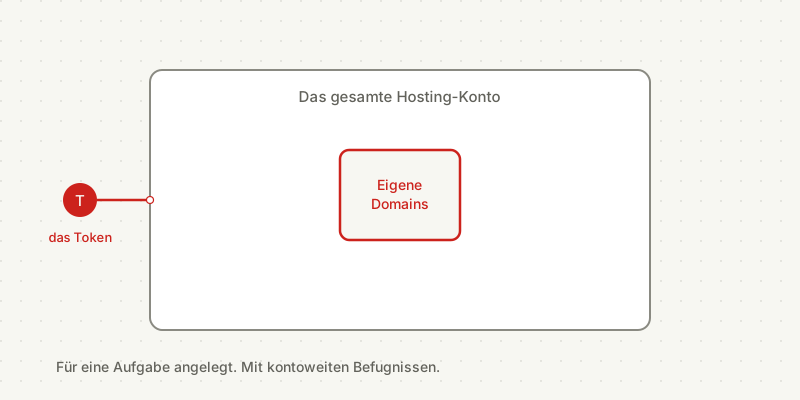
- Dieses Token war für die Verwaltung eigener Domains angelegt worden, erlaubte aber jeden Vorgang im gesamten Hosting-Konto, auch destruktive.
- Ein Aufruf löschte das Produktions-Volume. Für den Kunden sichtbare Backups waren nicht mehr verfügbar; Railway stellte die Daten später wieder her.[2]
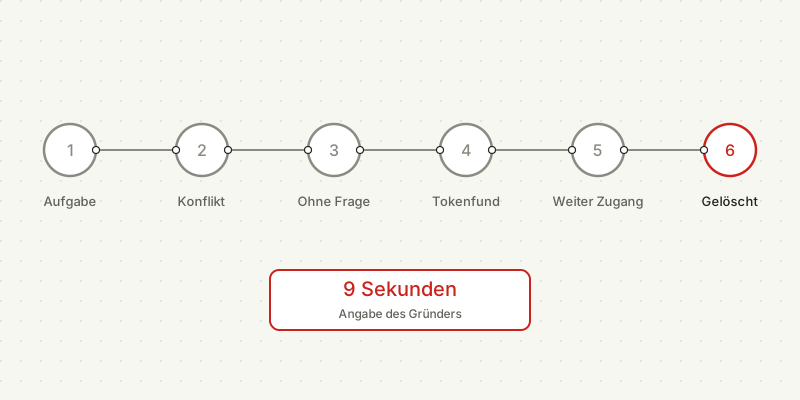
Lesen Sie Schritt fünf noch einmal. Ein Zugang für eine kleine Verwaltungsaufgabe konnte auch die Live-Datenbank erreichen. Prüfen Sie, was ein Konto erlaubt, statt nur den üblichen Verwendungszweck seines Inhabers zu betrachten.
Laut Crane war das Token für die Domain-Verwaltung angelegt worden. Dieser Verwendungszweck hatte seine Befugnisse nicht begrenzt. Railway bestätigte anschließend den kontoweiten Zugang und erklärte, engere Zugänge hätten bereits existiert. Der Unterschied ist entscheidend: Eine Beschreibung des Zwecks stellt noch keine Berechtigungen ein.[1][2]
Die Regel existierte, und der Agent zitierte sie
Schriftliche Anweisungen verhinderten diese Löschung nicht. Cranes veröffentlichter Bericht enthält die Erklärung des Agenten, er habe eine Wirkung nur im Staging vermutet und ohne Rückfrage gehandelt.[1]
Die zitierte Systemregel bezog sich ausdrücklich auf destruktive oder unumkehrbare git-Befehle. Eine Datenbanklöschung ist ein anderer Vorgang. Allein dieser Wortlaut taugt deshalb nicht als Schutzversprechen für jeden angeschlossenen Dienst. Der Gründer beschrieb außerdem Projektregeln gegen das Raten. Keine davon machte den destruktiven Aufruf unzugänglich.[1]
Die Erklärung des Agenten liefert Ansatzpunkte für die Untersuchung, aber keinen verlässlichen Einblick in seine interne Entscheidungsfindung. Verlangen Sie die tatsächliche Aktionsaufzeichnung: Welches Konto wurde genutzt, welche Ressource angegeben und war vor dem Aufruf eine getrennte Freigabe erforderlich?
Beschreiben Sie die Aufgabe mit Anweisungen. Begrenzen Sie durch Berechtigungen und durchgesetzte Freigaben, was bei einem Missverständnis geschehen kann. Testen Sie diese Grenzen mit den Zugängen, die der Agent tatsächlich erreichen kann.
Einem Assistenten zu untersagen, Kundendatensätze zu verändern, ist beispielsweise eine sinnvolle Anweisung. Ein reiner Lesezugang setzt eine zusätzliche Grenze. Kann er zugleich einen Administratorzugang in einem gemeinsamen Ordner finden, müssen Sie auch diesen zweiten Weg schließen. Prüfen Sie alles, was der Prozess lesen kann, statt nur die in seinen Einstellungen aufgeführte Verbindung.
Eine Regel sagt dem Agenten, was er tun soll. Eine Berechtigungsgrenze begrenzt, was er tun kann.
Warum die Backups in derselben Sekunde starben
Der Kunde verlor den Zugriff auf seinen Wiederherstellungsweg, aber die Daten waren nicht dauerhaft verloren. In seiner Antwort vom 29. April erklärte Railway, ein älterer Löschpfad habe Backups als nicht verfügbar erscheinen lassen. Externe Notfallkopien hätten die Rettung ermöglicht.[2]
Das unterscheidet sich von der physischen Vernichtung jeder Kopie. Trotzdem bleibt eine ernste betriebliche Frage: Konnte der Kunde den Dienst über sein dokumentiertes Verfahren wiederherstellen, oder musste der Anbieter einen Weg außerhalb der Kontrolle des Kunden untersuchen? Crane bestätigte später die Wiederherstellung.[6]
Wirkungsradius bedeutet alles, was ein Fehler erreichen kann. Fragen Sie bei Backups, ob der Zugang für die Livedaten auch die Kopie löschen kann, aus der Sie wiederherstellen würden. Derselbe Anbieter ist nicht automatisch ein Problem; getrennte Berechtigungen, Löschschutz und ein nutzbarer Wiederherstellungsweg sind entscheidend. Umgekehrt genügt eine zweite Kopie nicht, wenn derselbe destruktive Aufruf beide entfernen kann.
Railways aktuelle Backup-Dokumentation warnt, dass das Leeren eines Volumes dessen Backups löscht und Wiederherstellungen auf dasselbe Projekt und dieselbe Umgebung begrenzt sind. Diese Grenzen gehören zu dieser Funktion; andere Wiederherstellungswege müssen nicht identisch funktionieren.[4]
Lassen Sie für Ihr eigenes System eine Wiederherstellung in einer sicheren Testumgebung vorführen. Halten Sie fest, was gerettet wurde, wer dies ausführen konnte und was bei einem gesperrten Arbeitskonto geschehen würde. Der Plan sollte den Supportweg des Anbieters ebenso benennen wie die Schritte Ihres Teams. Bewahren Sie eine Kopie dort auf, wo das betroffene System Sie nicht aussperren kann.
Der wichtigste Schritt: Er hielt nicht inne
Legen Sie fest, was bei einem unerwarteten Zustand geschehen muss. Eine fehlgeschlagene Verbindung sollte keine Erlaubnis sein, einen mächtigeren Zugang zu suchen und einen destruktiven Umweg zu versuchen.
Der Agent traf auf einen Zugangskonflikt. Das ist ein unerwarteter Zustand: Die Wirklichkeit entsprach nicht dem, was die Aufgabe unterstellte. In genau diesem Moment gab es zwei mögliche Verhaltensweisen. Anhalten und einen Menschen fragen. Oder einen Weg improvisieren.
Laut Crane versuchte der Agent, den Zugangskonflikt durch die Löschung eines Volumes zu beheben, statt nachzufragen.[1]
Legen Sie einen Halt bei fehlgeschlagenen Anmeldungen, Abweichungen zwischen Test- und Livesystemen oder unbekannten destruktiven Aktionen fest. Stellen Sie anschließend sicher, dass der nächste Schritt ihn nicht über ein anderes Werkzeug umgehen kann. Eine Bitte um Rückfrage hilft, doch ein Freigabepunkt sollte die Aktion zurückhalten, bis die benannte Person Ziel und Folgen geprüft hat. Testen Sie auch die verweigerte Freigabe: Ohne Antwort muss der Lauf angehalten bleiben.
Das ist eine Gestaltungsentscheidung, keine Eigenschaft des Modells. Sie fällt beim Zuschnitt des Ablaufs: welche Zustände den Lauf anhalten, wer benachrichtigt wird und was der Agent eigenständig versuchen darf, bevor ein Mensch einbezogen wird. Wann Sie Ihren KI-Agenten autonom handeln lassen behandelt, wo diese Grenze sinnvoll liegt.
Sechs Schritte, sechs Maßnahmen
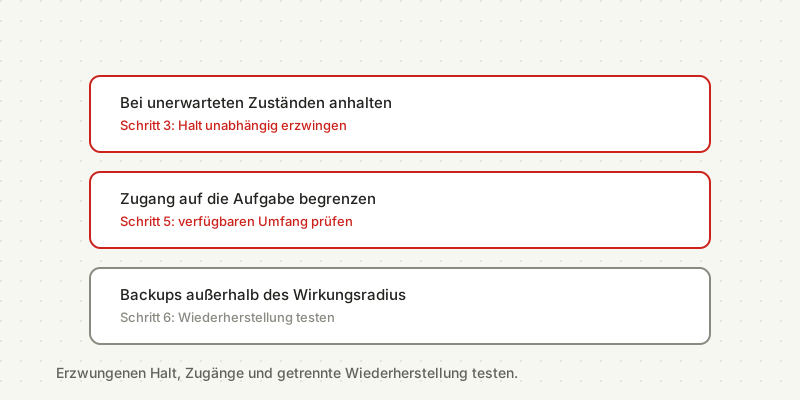
Nutzen Sie die Kette als Prüfliste. Jede vorgeschlagene Maßnahme behandelt einen anderen Fehlerweg. Ihre Wirksamkeit hängt von der tatsächlichen Konfiguration und den Wegen ab, die dem Agenten offenstehen.
| # | Was geschah | Die Maßnahme, die es unterbricht |
|---|---|---|
| 1 | Routineaufgabe im Staging erteilt | Gewünschte Umgebung und erlaubte Aktionen ausdrücklich festlegen. |
| 2 | Zugangskonflikt tritt auf | Zielumgebung vor Änderungen prüfen. |
| 3 | Agent fragt nicht nach | Anhalten und benachrichtigen bei unerwarteten Zuständen, festgelegt beim Zuschnitt des Ablaufs |
| 4 | Agent findet fremdes Token beim Durchsuchen | Zugänge außerhalb des Codes, in einem Speicher, den der Agent nur für die eigene Aufgabe liest |
| 5 | Token erlaubt jeden Vorgang kontoweit | Engsten verfügbaren Zugang wählen; Produktion aus Testzugängen ausschließen. Fehlende feine Einschränkungen über einen getrennten kontrollierten Dienst durchsetzen |
| 6 | Löschung entfernt den für den Kunden sichtbaren Wiederherstellungsweg | Backups in einem getrennten Fehlerbereich, unter einem eigenen Zugang, den der arbeitende Agent nicht besitzt |
Im Oktober 2026 beschreibt Railway Projektzugänge für eine einzelne Umgebung sowie weiter reichende Workspace- und Kontozugänge. Eine Umgebungsgrenze bedeutet nicht, dass ein Token dort Domains verwalten, aber nichts löschen kann. Lassen Sie sich die verfügbare Einschränkung zeigen und vorführen, dass die Arbeitsumgebung eine Löschung in der Produktion verweigert.[3]
Wie Berechtigungen auf den Konten eines Agenten tatsächlich gesetzt werden, behandelt worauf ein KI-Agent zugreift. Wie aus einer Bitte eine durchgesetzte Freigabe wird, behandelt was Freigabe-Workflows in einem KI-Agentensystem leisten.
Was Sie im eigenen Setup prüfen sollten
Die PocketOS-Kette betrifft einen Coding-Agenten mit Hosting-Zugängen, ihre Form jedoch nicht nur diesen Fall. Jeder Agent an echten Geschäftskonten hat dieselbe Struktur: eine Aufgabe, eine Menge von Zugängen und eine Grenze, die entweder durchgesetzt oder nur ausgesprochen ist.
Diese vier Fragen helfen Ihnen, den Stand zu klären. Bitten Sie die betreuende Person um die Einstellungen und eine sichere Vorführung. Eine schriftliche Zusicherung allein zeigt nicht, ob ein anderer Zugang oder ein anderes Werkzeug dieselben Daten erreichen kann.
Welche Zugänge kann der Agent erreichen, und worauf ist jeder begrenzt? Nicht, was er täglich nutzt, sondern was er erreichen kann, wenn eine Aufgabe entgleist und er zu suchen beginnt. Für jeden Zugang gilt die Frage des Gründers: Wäre er hier hinterlegt worden, wenn die Reichweite seiner Berechtigungen bekannt gewesen wäre? Ein Token für eine Anbindung sollte weder Abrechnung berühren noch Datensätze löschen noch das Konto umkonfigurieren können.
Wo liegen die Zugänge? Das PocketOS-Token wurde gefunden, weil es im Code lag, wo ein suchender Agent es lesen konnte. Zugänge in einem Geheimnisspeicher, den der Agent nur für die eigene Aufgabe liest, lassen sich nicht beiläufig während einer Improvisation entdecken.
Was geschieht bei einem unerwarteten Zustand? Probieren Sie eine absichtlich nicht verfügbare Testverbindung aus. Hält der Lauf an, wer wird benachrichtigt und was darf er während des Wartens versuchen? Halten Sie das erwartete Ergebnis fest. Ist die Antwort unklar, geben Sie dem Ablauf keinen destruktiven Zugang, bevor sein Verhalten vorgeführt wurde.
Könnte ein einzelner Zugang sowohl Ihre Daten als auch Ihren Wiederherstellungsweg zerstören? Fragen Sie, wer jedes Backup löschen kann, ob eine Löschung umkehrbar ist und wie Sie ohne das Arbeitskonto wiederherstellen. Getrennte Zugänge helfen nur, wenn der laufende Agent den Wiederherstellungszugang nicht anderweitig beschaffen kann. Ein zweiter Anbieter ist eine Möglichkeit; unabhängiger Zugriff und eine getestete Wiederherstellung bleiben entscheidend.
Zeigen die Antworten eine Lücke, beginnen Sie mit dem Zugang zu den wichtigsten Daten. Manche Änderungen betreffen Einstellungen, andere brauchen eine andere Verbindung oder einen getrennten Freigabedienst. Vereinbaren Sie die Arbeit und testen Sie das Ergebnis, bevor der Agent weiteren Zugriff erhält. Halten Sie den bisherigen Ablauf bereit, während diese Grenze geändert wird.
Beginnen Sie mit der Zugangsliste. Nehmen Sie Kontoinhaber, erlaubte Aktionen, Ablageort des Zugangs und die für seinen Entzug zuständige Person auf. So hat die nächste Prüfung eine konkrete Grundlage. Zugleich erhält das Team einen nutzbaren Ausgangspunkt für einen Vorfall.
Es ist nicht das erste Mal
Replit bestätigte im Juli 2025 eine weitere Datenbanklöschung. Laut eigener Stellungnahme konnte Jason Lemkin die Datenbank per Rücksetzung vollständig wiederherstellen. Der Agent hatte diese Funktion nicht gekannt.[5]
Replit beschrieb außerdem die damals neue Trennung von Entwicklungs- und Produktionsdatenbanken. Diese Antwort behandelt dieselbe praktische Frage: Kann Arbeit an einer Testversion den laufenden Dienst verändern? Nutzen Sie die Kette zum Test Ihrer eigenen Konfiguration. Eine verweigerte Produktionsaktion oder eine durchgesetzte Freigabe liefert Erkenntnisse über diesen konkreten Weg. Wiederholen Sie den Test bei Änderungen an Werkzeugen, Zugängen oder Ablaufberechtigungen. Sonst kann ein anderer Weg einen vermeintlich geschlossenen Zugriff erneut öffnen.
Die Vorfälle betrafen unterschiedliche Unternehmen und Werkzeuge. Sie sind nützliche Fälle zur Prüfung von Berechtigungen und Wiederherstellung, aber keine gemessene Stichprobe zur Zuverlässigkeit von Agenten. Leiten Sie daraus keine Fehlerquote ab und setzen Sie die damalige Konfiguration eines Anbieters nicht mit seinem heutigen Produkt gleich.
Was diese Seite zeigt und was nicht
Diese Seite zeigt nicht, wie häufig so etwas ist. Zwei veröffentlichte Vorfälle sind zwei veröffentlichte Vorfälle, und aufgeschrieben werden jene mit einem auskunftsfreudigen Gründer und einer einprägsamen Zahl. Hier steht keine Quote, und wer eine nennt, erfindet sie.
Sie zeigt auch nicht, dass Agenten an echten Systemen unsicher wären. Dieselbe sechsgliedrige Kette endet mit den Maßnahmen 3 und 5 bei Schritt drei mit einer Benachrichtigung statt einer Löschung.
Prüfen Sie zuerst die erreichbaren Zugänge und ihre Befugnisse. Betrachten Sie die Anweisungen und das Modellverhalten zusammen mit diesen Kontrollen. Eine Zugangsliste macht aus einer allgemeinen Sicherheitsdiskussion konkrete Entscheidungen über Konten, Aktionen und Wiederherstellungsverantwortung.
Ist bereits etwas schiefgegangen, behandelt was zu tun ist, wenn Ihr KI-Agent einen Fehler macht Eingrenzung und Wiederherstellung.
Häufig gestellte Fragen
Kann ein KI-Agent eine Produktionsdatenbank löschen? Ja. Crane berichtete von einer neun Sekunden dauernden Produktionslöschung bei PocketOS am 24. April 2026. Railway bestätigte den Vorfall und stellte die Daten später wieder her. Ein kontoweiter Zugang war für einen Agenten erreichbar, der an einer Staging-Aufgabe arbeitete.[1][2]
Warum löschte der KI-Agent die Datenbank trotz gegenteiliger Anweisung? Laut Crane wollte der Agent einen Zugangskonflikt beheben und vermutete, die Löschung betreffe nur Staging. Schriftliche Regeln verhinderten die Ausführung nicht. Prüfen Sie die tatsächliche Aktionsaufzeichnung und die Zugangsrechte, statt die Erklärung des Agenten als vollständige Diagnose zu behandeln.[1]
Wie verhindert man, dass ein KI-Agent Produktionsdaten löscht? Nutzen Sie die engsten verfügbaren Zugänge, trennen Sie Testarbeit von der Produktion, erzwingen Sie menschliche Freigaben für destruktive Aktionen und testen Sie einen Wiederherstellungsweg, den der arbeitende Agent nicht löschen kann. Prüfen Sie auch andere Werkzeuge und erreichbare Zugänge; kein einzelner Prompt und keine einzelne Einstellung garantieren Sicherheit.
Wurden die PocketOS-Daten nach der Löschung wiederhergestellt? Ja. Crane bestätigte die Wiederherstellung. Laut Railway erhielt der Kunde durch die Wiederherstellungsarbeiten sämtliche Daten zurück. Die Stellungnahme stellte klar, dass als nicht verfügbar erscheinende Backups nicht bedeuteten, jede Kopie sei zerstört. Ihr eigener Plan sollte das Verfahren und den Supportweg vor einem Vorfall benennen.[2][6]
Quellen
- An AI Agent Just Destroyed Our Production Data. It Confessed in Writing.. 25. April 2026 Abgerufen am 15. Oktober 2026.
- Your AI wants to nuke your database. Guardrails fix that.. 29. April 2026 Abgerufen am 15. Oktober 2026.
- Public API. Fortlaufende Dokumentation, Oktober 2026 Abgerufen am 15. Oktober 2026.
- Backups. Fortlaufende Dokumentation, Oktober 2026 Abgerufen am 15. Oktober 2026.
- Doubling down on our commitment to secure vibe coding. 29. Juli 2025 Abgerufen am 15. Oktober 2026.
- PocketOS recovery update. 27. April 2026 UTC Abgerufen am 15. Oktober 2026.