Für Unternehmen, die den Weg ihrer KI-Daten erklären müssen, trennt dieser Leitfaden den Agentenrechner, gespeicherte Daten und Modellverarbeitung. Er vergleicht Anbieterwege und zeigt die Einstellungen vor einer Zusage zur europäischen Verarbeitung.
Das erfahren Sie
- Wie sich Speicherort und Verarbeitungsort unterscheiden
- Welche Anbietereinstellungen die KI-Anfrage auf Europa begrenzen
- Warum EU-Grenzen je Anbieter unterschiedlich sind
- Welche Systemdaten und Drittanbieterwege separat zu prüfen sind
- Was Sie vom Betreiber Ihres Setups anfordern sollten
Angenommen, ein Kunde fragt, wo seine Daten landen. Sie öffnen die Datenschutzseite Ihres Anbieters, finden das Wort „Europa" und schreiben beruhigt zurück. Diese Antwort kann an der Frage vorbeigehen, wenn die Seite Speicherung beschreibt, der Kunde aber Verarbeitung meint.
Der Verarbeitungsort eines KI-Agenten hängt vom Setup ab. Microsofts Global-Typen dürfen Prompts in jeder Azure-Region verarbeiten.[1] Googles globale Option begrenzt die Verarbeitungsregion nicht.[2] OpenAI bietet freigegebene regionale Verarbeitung mit modellabhängigem Aufschlag.[4]
Fragen Sie nach Bereitstellungstyp und tatsächlichem Weg, bevor Sie einem Kunden antworten. Ein Land im Ressourcennamen oder eine Speicherzusage beantwortet nur einen Teil der Frage.
Wo werden die Daten eines KI-Agenten tatsächlich verarbeitet?
KI-Agenten-Daten können auf dem Rechner des Agenten und beim aufgerufenen KI-Dienst verarbeitet werden. Wählen Sie den Standort des Rechners und prüfen Sie die separate Verarbeitungszusage jedes externen Dienstes.
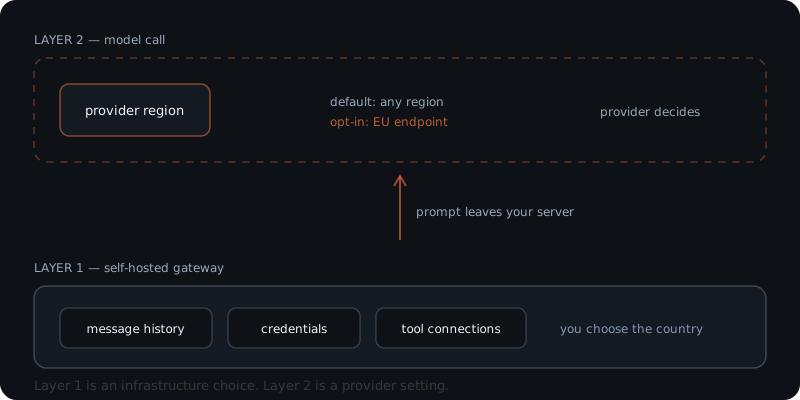
Ebene eins ist der Agent selbst — die Software, die Ihren Nachrichtenverlauf, Ihre Zugangsdaten und die Verbindung zu Gmail oder CRM hält. Bei einem selbst gehosteten System läuft sie auf einem Server, den Sie mieten und kontrollieren, und dessen Land Sie beim Einrichten festlegen. OpenClaw betreibt ein Gateway auf einem von Ihnen gewählten Rechner. Das Gateway hält Verbindungen zu externen Diensten; sein Standort bestimmt nicht den Ort jedes verbundenen Tools oder Modellaufrufs.[10]
Ebene zwei ist der Modellaufruf. Immer wenn der Agent entwerfen, zusammenfassen oder einordnen soll, schickt er Text an einen Modellanbieter. Diese Anfrage verlässt Ihren Server. Wo sie ankommt, regeln die Einstellungen des Anbieters — nicht Ihre, sofern Sie sie nicht konfigurieren.
Verfolgen Sie bei einer Kundenanfrage beide Wege: wo der Agent die Nachricht hält und wo die gewählte KI den gesendeten Inhalt verarbeitet. Beziehen Sie E-Mail, Suche und Dateispeicher ein, wenn diese einen Teil des Inhalts erhalten.
„In Europa gespeichert" und „in Europa verarbeitet" sind zwei getrennte Zusagen. Ein Anbieter kann die erste einhalten und die zweite nicht — im selben Produkt, im selben Satz, und dabei die Wahrheit sagen. Microsofts Dokumentation formuliert es genau so: Ruhende Daten bleiben in der zugewiesenen Azure-Geografie, während eine Global-Bereitstellung Inferenzdaten in jeder Azure-Region verarbeiten darf.
Warum „in Europa gespeichert" und „in Europa verarbeitet" verschiedene Zusagen sind
Speicherung ist der Ort, an dem Daten liegen, wenn nichts mit ihnen geschieht. Verarbeitung ist der Ort, an dem gerechnet wird. Prüfen Sie beides separat: Die Speichereinstellung legt den Ort gespeicherter Inhalte fest; die Verarbeitungsoption bestimmt den Ort der Modellanfrage.[3]
Googles Dokumentation ist bei dieser Trennung am deutlichsten. Sie unterscheidet ruhende Daten von der ML-Verarbeitung und hält fest, dass am gewählten Ort gespeicherte Daten dort bleiben — unabhängig davon, welcher Endpunkt für die Anfrage aufgerufen wird. Der Endpunkt entscheidet die Verarbeitung, die Speichereinstellung entscheidet die Speicherung. Zwei Regler.
Dann folgt der Satz, der die meisten dieser Diskussionen beenden sollte: Endpunkte garantieren weder Datenresidenz noch ML-Verarbeitung innerhalb der Region. Und zum globalen Endpunkt ausdrücklich: Nutzen Sie ihn nicht, wenn Sie Anforderungen an den Verarbeitungsort haben — denn Sie können weder steuern noch wissen, in welche Region eine Anfrage geleitet wurde.
Bei einem Kundenvertrag mit erlaubten Ländern brauchen Sie den unterstützten regionalen Weg. Ein globaler Weg gibt diese Zusage nicht allein deshalb, weil Ihre Dateien in Europa gespeichert sind.[2]
Was die einzelnen Anbieter standardmäßig tun
Stand Oktober 2026 hängen diese KI-Residenzoptionen von Dienst, Modell und Routing-Einstellung ab. Eine globale und eine EU-begrenzte Option können im selben Konto verfügbar sein.[1][2][4]
| Anbieter | Zu prüfende Verarbeitungseinstellung | EU-Verarbeitungsoption | Preis oder Voraussetzung |
|---|---|---|---|
| Microsoft Foundry / Azure OpenAI | Global-Typen dürfen jede Azure-Region nutzen.[1] | Unterstützte EU-Data-Zone-Typen oder geografische Bereitstellung | Modellverfügbarkeit und Tarif unterscheiden sich; Global Standard ist die allgemeine Einstiegsempfehlung |
| Google Cloud / Gemini | Global begrenzt die Verarbeitung nicht regional.[2] | Unterstütztes Modell an aiplatform.eu.rep.googleapis.com; nur EU-Mitgliedstaaten.[3] | Modell- und Funktionsverfügbarkeit prüfen |
| OpenAI API | Globale Aufrufe haben keine Verarbeitungsgrenze.[4] | Geeignete Modelle/Dienste an eu.api.openai.com, je Projekt oder Anfrage | 10 % Aufschlag für geeignete Modelle ab 5. März 2026; Vertriebseignung und Freigabe der Speicherregeln außerhalb der USA |
| AWS Bedrock | Das gewählte Profil bestimmt die Ziele.[5] | EU-Geografieprofil aus einer EU-Quellregion | Modell, Quelle und Ziele prüfen; Regeln für UK/Schweiz unterscheiden sich |
| Mistral | Kunde wählt Europa oder USA.[8] | Unterstützter europäischer regionaler Endpunkt | Vertrag und Tarif prüfen; abgesicherte Unterauftragsverarbeiter-Übermittlungen können die Region verlassen |
| Anthropic direkte API | Global ist Standard; eine reine US-Option ist dokumentiert.[7] | EU-Verarbeitung über unterstützten Bedrock- oder Google-Cloud-Weg | Direkter API-Workspace speichert derzeit nur in den USA; Region/Modellbedingungen des Partners gelten |
Vergleichstabelle zur KI-Datenresidenz als deutsches PDF herunterladen.
Drei Punkte aus dieser Tabelle gehören hervorgehoben, weil sie Entscheidungen verändern.
Microsoft empfiehlt die unbeschränkte Variante. In der Dokumentation heißt es, man solle für die meisten Workloads mit Global Standard beginnen. Global Standard ist genau der Bereitstellungstyp, der in jeder Azure-Region verarbeiten darf. Als technische Empfehlung ist das schlüssig — neueste Modelle, niedrigster Preis, breiteste Regionsabdeckung. Diese Option gibt keine reine EU-Inferenzzusage, nur weil die Ressource in Europa liegt.[1]
OpenAIs EU-Verarbeitung hat einen Preis. Endpunkte mit Datenresidenz kosten zehn Prozent Aufschlag für Modelle, die am oder nach dem 5. März 2026 erschienen sind und für Datenresidenz infrage kommen. Sie ist außerdem nicht selbst freischaltbar: Die Eignung klärt der Vertrieb, und jede Region außerhalb der USA verlangt zusätzlich eine Freigabe für Missbrauchskontrollen sowie eine geänderte Vereinbarung zur Datenspeicherung.
Auch bei OpenAI sind Speicherung und Verarbeitung getrennt zu prüfen. Die Regionswahl sorgt dafür, dass Inhalte dort ruhend gespeichert werden. Die Inferenz folgt nur, wenn die gewählte Region regionale Verarbeitung unterstützt. Tut sie das nicht, darf OpenAI Kundeninhalte auch außerhalb der Region verarbeiten und vorübergehend speichern.
Wo mehr als 300 KI- und Arbeitstools Daten standardmäßig speichern und welche Tarife die EU anbieten: KI mit Servern in der EU, Tarif für Tarif.
Welches „Europa" meint Ihr Anbieter?
Die Anbieter sind sich nicht einig, welche Länder „die EU“ umfasst, und die Differenz ist nicht klein. Zwei von ihnen ziehen die Grenze so, dass ein Schweizer Unternehmen gegenteilige Antworten erhält.
| Anbieter | Was seine EU-Grenze umfasst |
|---|---|
| Microsoft EU Data Boundary | EU-Mitgliedstaaten, und kann EFTA-Staaten wie Norwegen und die Schweiz einschließen |
| AWS EU-übergreifende Inferenz | EU-Quellen bleiben in EU-Zielen; London-/Zürich-Quellen dürfen zusätzlich in ihrer eigenen Quellregion verarbeiten.[5] |
| Google EU-multiregional | EU-Mitgliedstaaten; UK und Schweiz sind ausdrücklich ausgeschlossen.[3] |
| Mistral regionale Endpunkte | Europa oder USA, vorbehaltlich begrenzter, abgesicherter Übermittlungen an Unterauftragsverarbeiter außerhalb der Region |
Zwei Anbieter können beide zusagen, Ihre Daten „in der EU" zu halten, und dabei verschiedene Länder meinen. Einer schließt die Schweiz ein. Der andere schließt Zürich ausdrücklich aus.
Für die meisten Unternehmen ist das akademisch. Für eine Schweizer Firma, ein österreichisches Unternehmen mit Schweizer Kunden oder jeden, dessen Vertrag konkrete Länder statt „die EU" nennt, ist es die ganze Frage. Microsofts Grenze kann die Schweiz einbeziehen; Amazons Routing-Regeln halten Zürich bewusst aus der EU-Zielmenge heraus und behandeln den Standort stattdessen als eigene Quellregion. Ein EU-Profil aus Zürich darf auch in Zürich verarbeiten; aus London darf es auch London nutzen.[5]
Microsoft behält sich zudem vor, die Linie zu verschieben: Regionen können ohne vorherige Ankündigung zu einer Datenzone hinzugefügt werden, um Kapazität und Verfügbarkeit zu verbessern. Eine im März geprüfte Grenze ist nicht zwingend die Grenze, die im September gilt.
Was die Region trotz aktivierter Residenz verlässt
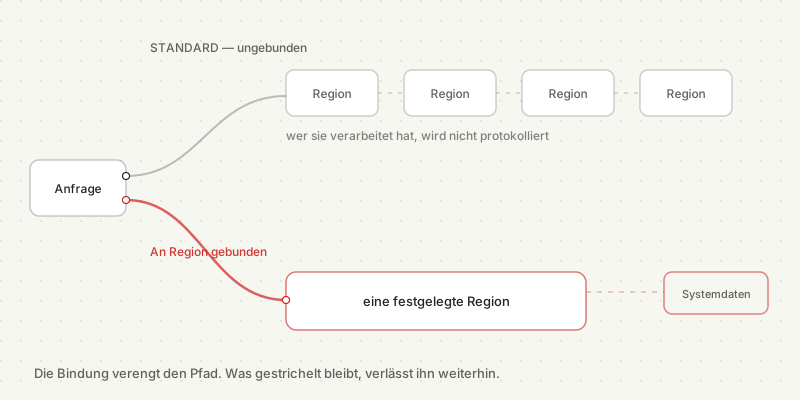
Residenz einzuschalten verengt den Weg. Es schließt ihn nicht, und die Anbieter dokumentieren die Lücken.
Systemdaten sind ausgenommen. OpenAI hält fest, dass Datenresidenz nicht für Systemdaten gilt, und definiert diese weit: Kontodaten, Metadaten, Nutzungsdaten, Analysen, Nutzungsstatistiken, Abrechnungsdaten, Supportanfragen — und Schemata für strukturierte Ausgaben. Der letzte Punkt lohnt ein zweites Lesen. Wenn Ihr Agent das Modell auffordert, JSON in einer definierten Form zurückzugeben, ist diese Form selbst ein Systemdatum. Die Feldnamen eines Schemas können ein Geschäft ziemlich genau beschreiben.
Unterauftragsverarbeiter liegen außerhalb der Zusage. Mistral formuliert das präzise: Inferenz und zugehörige Verarbeitung finden in der gewählten Region statt — vorbehaltlich begrenzter, abgesicherter Übermittlungen an Unterauftragsverarbeiter außerhalb dieser Region. Prüfen Sie diese Ausnahme in der Mistral-Vereinbarung für den genutzten Dienst.[8]
Einzelne Tarife sind ausgenommen. Microsofts Developer-Bereitstellungstyp zur Bewertung feinabgestimmter Modelle enthält überhaupt keine Zusagen zur Datenresidenz. Es ist ein enger Tarif mit 24 Stunden Lebensdauer — also genau das, was jemand für einen schnellen Test mit echten Daten nimmt.
Ihre eigenen Nutzer können es aushebeln. OpenAI merkt an, dass Residenz keine Übermittlung oder Speicherung abdeckt, die durch den Standort eines Endnutzers oder der Kundeninfrastruktur beim Zugriff entsteht. Regional fixierte Verarbeitung hilft nicht, wenn die Person am Agenten woanders sitzt.
Nichts davon macht EU-Verarbeitung sinnlos. Es macht die Zusage schmaler, als sie klingt: Sie deckt Kundeninhalte im Modellaufruf ab, nicht jedes Byte, das der Dienst berührt. Das bleibt der Unterschied zwischen einer dokumentierten Übermittlungsgrundlage und einer unbekannten — und daran hängen Ihre Pflichten aus der DSGVO.
Welcher Teil davon ist Ihre Entscheidung?
Sie wählen den Rechner des Agenten und die gebuchte Verarbeitungsoption. Der Anbieter definiert deren geografische Grenze und Ausnahmen; halten Sie diese separat fest.
| Frage | Wer entscheidet | Woran es hängt |
|---|---|---|
| In welchem Land das Agenten-Gateway läuft | Sie | Der Server, den Sie bereitstellen |
| Wo Nachrichtenverlauf und Zugangsdaten liegen | Sie | Derselbe Server |
| Welchen Modellanbieter der Agent aufruft | Sie | Konfiguration |
| In welcher Region dieser Anbieter verarbeitet | Die Einstellungen des Anbieters, von Ihnen gewählt | Bereitstellungstyp, Endpunkt oder Domain-Präfix |
| Was der Anbieter mit Systemdaten tut | Der Anbieter | Seine Bedingungen |
| Welche Länder als „EU" zählen | Der Anbieter | Seine Grenzdefinition |
Die ersten drei Zeilen sind gewöhnliche Infrastrukturentscheidungen. Ein selbst gehostetes Gateway läuft dort, wo Sie es hinstellen, die Hostingkosten hängen von Dienst und Kapazität ab. Vergleichen Sie die Regionsangebote, statt kostenlose Standortwahl vorauszusetzen. Diesen Teil halten die meisten Käufer für schwierig, und er ist der einfache.
Die letzten drei Zeilen muss man lesen. Sie ändern sich außerdem, ohne dass Sie etwas tun — deshalb brauchen sie ein Prüfdatum und keine einmalige Entscheidung.
Das ist eine andere Frage als die, worauf der Agent überhaupt zugreifen darf. Berechtigungen entscheiden, was er sehen kann; Residenz entscheidet, wo das Gesehene verarbeitet wird. Ein eng zugeschnittener Agent, der in einer unbekannten Region verarbeitet, bleibt eine Übermittlung, die Sie nicht belegen können.
So prüfen Sie, wo Ihr eigenes Setup verarbeitet
Fordern Sie diese fünf dokumentierten Einstellungen vom Betreiber Ihres KI-Setups an. Er sollte Konfiguration und passende Zusage zeigen können; ein beruhigender Produktname reicht nicht.
Suchen Sie den Bereitstellungstyp, nicht den Regionsnamen. Eine Azure-Ressource in „West Europe" mit einer Global-Standard-Bereitstellung ist eine westeuropäische Ressource, die überall verarbeitet. Nicht die Region im Namen ist die Antwort, sondern das SKU. Fragen Sie, welcher Bereitstellungstyp läuft und ob er mit Global oder DataZone beginnt.
Prüfen Sie die Basis-URL der API. Bei OpenAI trägt ein Aufruf an api.openai.com ohne Präfix keine Verarbeitungsbeschränkung. eu.api.openai.com wählt den EU-Weg für geeignete Modelle und Dienste. Prüfen Sie neben der Adresse auch Freigabe, Modell und Funktionsunterstützung.[4]
Fragen Sie bei Google nach dem Endpunkt. Der globale Endpunkt und aiplatform.eu.rep.googleapis.com sind zwei verschiedene Zeichenketten in derselben Konfiguration. Nur eine davon beschränkt die Verarbeitung.
Fragen Sie bei Bedrock nach dem Inferenzprofil. Ein EU-Profil aus einer EU-Quellregion hält diese Anfragen in EU-Zielen. Eine Londoner oder Zürcher Quelle darf zusätzlich die eigene Region nutzen; ein globales Profil kann andere unterstützte Regionen erreichen.[5] Sitzt Ihr Unternehmen in Zürich oder London, fragen Sie ausdrücklich nach der Behandlung dieser Standorte — unter dem EU-Profil sind sie keine EU-Ziele.
Lassen Sie sich die Übermittlungsgrundlage schriftlich geben, nicht die Marketingseite. Verlässt ein Teil des Weges den EWR, braucht es eine dokumentierte Grundlage: einen Angemessenheitsbeschluss, Standardvertragsklauseln oder eine Ausnahme. Ordnen Sie den Vertrag dem kommerziellen Dienst zu, der Ihre Kundeninhalte erhält. Eine Verantwortlichenadresse in einer Verbraucher-Datenschutzerklärung ist keine API-Verarbeitungszusage; Anthropics kommerzielle Hinweise beschreiben standardmäßig Routing über mehrere Länder.[6] Beruft sich ein US-Anbieter auf einen Angemessenheitsbeschluss, ist die Prüfung, ob er auf der offiziellen Teilnehmerliste des EU-US Data Privacy Framework steht: dataprivacyframework.gov. Nachschlagen statt glauben.
Wer diese fünf Punkte durchgeht, kann die Frage eines Kunden mit einem Satz beantworten, der auch die Rückfrage übersteht. Das ist eine deutlich andere Lage als „unser Anbieter sagt Europa".
Was die Datenresidenz nicht sagt
Die KI-Residenzoptionen entsprechen dem Stand Oktober 2026. Dieser Vergleich ist keine Rechtsberatung und bescheinigt keinem Anbieter DSGVO-Konformität — diese Bewertung hängt an Ihren Daten, Ihren Zwecken und Ihren Verträgen und gehört zu einer qualifizierten Datenschutzfachkraft.
Drei Grenzen ausdrücklich benannt. Regionsrichtlinien der Anbieter ändern sich, teils erklärtermaßen ohne Ankündigung; jede Zeile trägt daher ein Abrufdatum und sollte vor einer Entscheidung erneut geprüft werden. Der Zertifizierungsstatus unter dem EU-US Data Privacy Framework wird hier für keinen Anbieter behauptet, weil die offizielle Liste die einzige belastbare Quelle ist und Sie sie selbst lesen sollten. Und wo verarbeitet wird, sagt nichts darüber, ob der Anbieter mit dem Gesendeten trainiert — das ist eine eigene Frage mit eigenen Antworten je Tarif.
Das brauchbare Ergebnis ist schmaler als Gewissheit und nützlicher als Beruhigung: Sie können benennen, wo jeder Abschnitt des Weges läuft, und Sie können es belegen.
Häufig gestellte Fragen
Wo werden meine Daten gespeichert, wenn ich einen KI-Agenten nutze? An zwei getrennt entschiedenen Orten. Die Arbeitsdaten des Agenten — Nachrichtenverlauf, Zugangsdaten, verbundene Dateien — liegen dort, wo die Agentensoftware läuft. Bei einem selbst gehosteten System ist das Ihr eigener Server. Die Prompts an das Modell gehen dorthin, wo der jeweilige Anbieter sie verarbeitet, und das ist eine separate Einstellung in dessen Hand. Für Ihr Unternehmen muss die Frage deshalb zweimal beantwortet werden, einmal je Ebene.
Bleiben KI-Daten in der EU? Eine EU-Verarbeitungszusage hängt von Dienst und Einstellung ab. Microsoft Global und Google global begrenzen die Inferenz nicht auf die EU. Unterstützte EU-Optionen gibt es bei Microsoft, Google, OpenAI, Bedrock und Mistral; prüfen Sie Modelleignung, Quellregion und Ausnahmen vor einer Zusage.
Was ist der Unterschied zwischen Datenresidenz und Verarbeitungsort? Datenresidenz meint in der Regel den Speicherort ruhender Daten. Der Verarbeitungsort ist der Ort, an dem die Modellberechnung läuft. Das sind zwei getrennte Zusagen, und sie werden regelmäßig verwechselt. Microsofts Dokumentation hält fest, dass ruhende Daten in der zugewiesenen Azure-Geografie bleiben, während Inferenzdaten bei einer Global-Bereitstellung in jeder Azure-Region verarbeitet werden dürfen. Beide Sätze gelten gleichzeitig — deshalb führt es in die Irre, nur den ersten zu lesen.
Bedeutet eine EU-Region, dass meine Daten die EU nie verlassen? Nein, und die Anbieter sagen das auch. OpenAI hält fest, dass Datenresidenz nicht für Systemdaten gilt, wozu Kontodaten, Metadaten, Nutzungsstatistiken, Abrechnungsdaten, Supportanfragen und Schemata für strukturierte Ausgaben zählen. Mistral sagt zu, dass die Inferenz in der gewählten Region stattfindet — vorbehaltlich begrenzter, abgesicherter Übermittlungen an Unterauftragsverarbeiter außerhalb dieser Region. Die Zusage deckt die Kundeninhalte im Modellaufruf ab, nicht alles, was der Dienst berührt.
Welche Länder zählen für einen KI-Anbieter als EU? Das hängt vom Anbieter ab, und sie sind sich uneinig. Microsofts EU Data Boundary kann neben EU-Mitgliedstaaten auch EFTA-Staaten wie Norwegen und die Schweiz einschließen. Amazons EU-übergreifende Inferenz macht das Gegenteil: Anfragen aus EU-Quellregionen dürfen nicht in Nicht-EU-Regionen geleitet werden, und Zürich und London gelten ausdrücklich nicht als EU-Ziele. Gleiches Wort, andere Landkarte.
Quellen
Alle Anbieterzeilen geprüft am 14. Oktober 2026.
- Microsoft, Foundry deployment types. Abruf: 14. Oktober 2026. Global/DataZone/geografische Verarbeitung, EFTA-Grenzen und Developer-Ausnahme mit 24 Stunden.
- Google Cloud, Deployments and endpoints. Abruf: 14. Oktober 2026. Globale und multiregionale Wege.
- Google Cloud, Data residency. Abruf: 14. Oktober 2026. Trennung von Speicher und Verarbeitung; politische EU-Grenze.
- OpenAI, Data controls. Abruf: 14. Oktober 2026. Eignung, Modellgrenze 5. März 2026, EU-Routing und Ausnahmen für Systemdaten/Dritte.
- AWS, EU cross-region inference. Abruf: 14. Oktober 2026. EU/UK/Schweiz: von der Quelle abhängige Ziele.
- Anthropic, Commercial server locations. Abruf: 14. Oktober 2026. Kommerzielles Routing; Verantwortlichenadresse bestimmt keinen API-Ort.
- Anthropic, API data residency. Abruf: 14. Oktober 2026. Direkte Inferenz und Workspace-Grenzen; Partnerwege separat.
- Mistral, Regional inference. Abruf: 14. Oktober 2026. Regionswahl und Übermittlungsvorbehalt.
- US Department of Commerce, Participant list. Abruf: 14. Oktober 2026. Eigene Prüfung des Lesers; kein Zertifizierungsstatus behauptet.
- OpenClaw, Gateway architecture. Abruf: 14. Oktober 2026. Gateway auf eigenem Rechner und Verbindungen zu externen Diensten.
