Tokenverbrauch und deutsche Schreibqualität brauchen getrennte Prüfungen. Messen Sie Ihre Texte und prüfen Sie Kundennachrichten auf Wortwahl, Fakten und Anrede.
Das erfahren Sie
- Behandeln Sie die Bestandswerte als datierte Messung, nicht als allgemeinen Aufschlag.
- Prüfen Sie die Benchmark-Aufgabe vor dem Wertevergleich.
- Nutzen Sie repräsentative Kundennachrichten und prüfen Sie das tatsächliche Ergebnis.
Die Sorge ist konkret und berechtigt. Ihr Agent soll Ihrer Kundschaft auf Deutsch schreiben, und Sie befürchten, dass dabei etwas herauskommt, das ordentlich wirkt und doch fein danebenliegt — das Register leicht verrutscht, die Formulierung leicht übersetzt, genau die Sorte Text, die ein deutscher Kunde sofort bemerkt und nie anspricht.
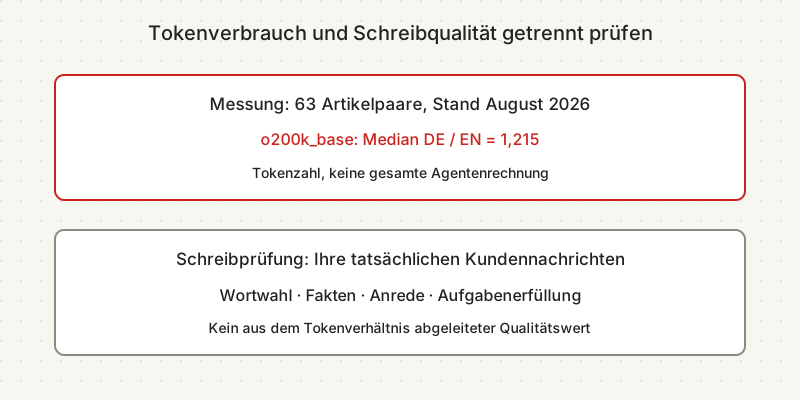
Behandeln Sie Tokenverbrauch und Schreibqualität als getrennte Entscheidungen. Ein günstigerer Text ist nicht automatisch die bessere Nachricht; flüssiges Deutsch kann trotzdem den falschen Betrag, Termin oder Gruß enthalten.
Der Tokenunterschied lässt sich für einen bestimmten Bestand messen. Der Stand mit 63 Artikelpaaren hat unter o200k_base einen Medianaufschlag von 21,5 % für Deutsch. Das bestimmt nicht Ihre gesamte Agentenrechnung: Encoding, Ein- und Ausgabepreise sowie der übrige Ablauf zählen ebenfalls.[1][8]
Die Qualität braucht eine andere Prüfung. Eine Studie über übersetzungsartige Formulierungen kann einen bestimmten sprachlichen Effekt untersuchen. Daraus folgt nicht, dass jedes aktuelle Modell Geschäftsdeutsch ebenso gut wie Englisch schreibt. Nutzen Sie die Befunde für Prüffragen und testen Sie Ihren eigenen Ablauf.[2]
Warum kostet Deutsch im Betrieb mehr als Englisch?
Im Yardwork-Bestandsstand vom August 2026 brauchte Deutsch mit o200k_base im Median 21,5 % mehr Tokens. Tokens sind die hier gezählten Texteinheiten, keine Wörter. Unter einem anderen Encoding ergeben dieselben Texte ein anderes Verhältnis.[1][7]
Die Messung umfasst 63 veröffentlichte Artikelpaare derselben Website, eingefroren vor der Veröffentlichung dieses Artikels. Die Aufbereitung entfernt Frontmatter, Bildkomponenten, Tabellenzeilen und Linksyntax und vergleicht den restlichen Text. Gemessen werden diese Fassungen, keine kontrollierten Übersetzungen identischer Formulierungen und keine repräsentative Stichprobe sämtlicher deutscher Geschäftstexte.[1]
| Kennzahl | o200k_base | cl100k_base |
|---|---|---|
| Median Token-Verhältnis Deutsch zu Englisch | 1,215 | 1,504 |
| Mittelwert | 1,204 | 1,473 |
| Spannweite über alle Paare | 0,908 – 1,366 | 1,097 – 1,680 |
| Paare mit mehr deutschen Tokens | 60 von 63 | 63 von 63 |
| Summen über den Bestand | 157.740 EN / 189.087 DE Tokens | — |
Zwei Punkte in dieser Tabelle wiegen schwerer als die Schlagzeile.
Das Encoding zählt. Derselbe Bestand hat unter cl100k_base einen Medianaufschlag von 50,4 % und unter o200k_base von 21,5 %. Dieser Vergleich sagt keine künftigen Verbesserungen voraus und bestimmt nicht das Encoding jedes aktuellen Modells. Fragen Sie nach dem tatsächlichen Encoding Ihres Dienstes.[1]
Drei Paare liefen andersherum. Bei drei von 63 Paaren benötigte Deutsch unter o200k_base weniger Tokens. Die Tendenz im Bestand ist deutlich, garantiert aber keinen höheren Wert für jeden zweisprachigen Text.[1]
Warum deutsche Ausgabe mehr kostet, auch wenn die Wörter kürzer sind
Die deutschen Fassungen dieses Bestands nutzen im Median weniger Wörter und trotzdem mehr Tokens. Vergleichen Sie beide Maße, bevor Sie die Kosten Ihrer eigenen Korrespondenz schätzen.[1]
| Verhältnis Deutsch ÷ Englisch (Median) | Wert |
|---|---|
| Wörter | 0,907 |
| Zeichen | 1,081 |
| Tokens | 1,215 |
| Tokens pro Wort | EN 1,208 · DE 1,654 |
Das mediane Wortverhältnis beträgt 0,907 und das Zeichenverhältnis 1,081: rund 9 % weniger Wörter und 8 % mehr Zeichen auf Deutsch. Die medianen Tokens pro Wort betragen 1,208 für Englisch und 1,654 für Deutsch; der daraus berechnete Abstand zwischen diesen Medianen beträgt 36,9 %.[1]
Eine Wortzählung allein kann daher täuschen. Ein deutsches Kompositum bleibt für Leser ein Wort, während das Encoding mehrere Teile daraus macht. Die genaue Zerlegung hängt vom Encoding und umgebenden Text ab.[7]
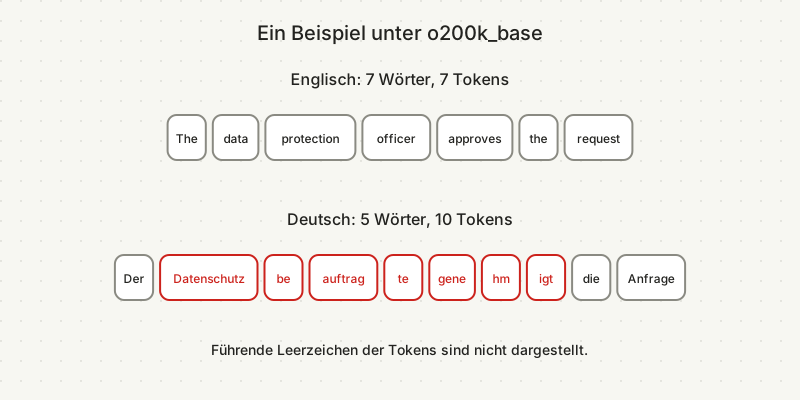
Ein konkretes Beispiel: The data protection officer approves the request hat unter o200k_base sieben Wörter und sieben Tokens. Der Datenschutzbeauftragte genehmigt die Anfrage hat fünf Wörter und zehn Tokens. Die gemessene Zerlegung enthält Datenschutz | be | auftrag | te und gene | hm | igt; führende Leerzeichen gehören zu manchen Tokenstücken.[1][7]
Bei gleichem Preis pro Token innerhalb derselben Abrechnungskategorie bedeuten mehr Tokens höhere Textkosten. Vergleichen Sie Ein- und Ausgabe sowie weitere Entgelte des tatsächlichen Ablaufs, bevor Sie aus diesem Bestandsverhältnis ein Budget ableiten.[8]
Woran erkennt man KI-geschriebenes Deutsch?
Die Translationese-Studie vom August 2026 fand einen Unterschied zwischen automatischer Einstufung und menschlichem Urteil. Bei deutschen Ausgaben von Gemini 2.0-Flash-001 stufte der Klassifikator 60,2 % als übersetzungsartig ein; die muttersprachliche Person markierte im kleinen annotierten Teil keine davon so. Bei Llama 3.3-70B-Instruct erreichten menschliche Einstufungen 37,5 %, einschließlich 12,5 % mehrdeutiger Fälle.[2]
Die Studie umfasst fünf Sprachen; menschliche Annotationen betreffen Deutsch und Spanisch. Der menschliche Prüfbestand enthält 60 Sätze je Sprache über verschiedene Konfigurationen, nicht 60 Sätze je Modell. Untersucht werden übersetzungsartige Formulierungen, keine Faktentreue, allgemeine Schreibqualität oder Erkennbarkeit der KI-Urheberschaft.[2]
Ein Wert für übersetzungsartigen Stil und das Urteil eines Lesers beantworten unterschiedliche Fragen.
Prüfen Sie für Ihre Kundenarbeit das vorgesehene Modell mit seinen tatsächlichen Anweisungen. Diese Ergebnisse bestimmen weder einen allgemeinen Qualitätsabstand zwischen Deutsch und Englisch noch eine Rangfolge sämtlicher aktueller Modelle.
Die Begründungen der Annotation betrafen hauptsächlich ungewöhnliche Wörter und Wortkombinationen. Das gibt der Prüfung einen konkreten Ansatz: Eine Formulierung kann grammatisch richtig und in der Situation trotzdem ungewohnt sein. Prüfen Sie Faktentreue, Ton und Aufgabenerfüllung auf getrennten Zeilen.[2]
Probieren Sie bei Wortwahlproblemen ein Glossar und freigegebene Beispiele aus und wiederholen Sie den Test. Enthält die Nachricht falsche Fakten oder fehlt eine Geschäftsbedingung, untersuchen Sie auch Ausgangsinformationen und Ablauf. Keine Kategorie ist automatisch dauerhaft behoben oder grundsätzlich unverbesserbar.
Die Autoren diskutieren mögliche Erklärungen durch übersetztes Trainingsmaterial und sprachübergreifende Verarbeitung. Das sind Hypothesen zum beobachteten Muster, keine Messungen der Kundenkorrespondenz Ihres gewählten Modells.[2]
Nutzen Sie diese Unterscheidung zusammen mit den tatsächlichen Schwächen von KI-Agenten: Untersuchen Sie den konkreten Fehler, statt den gesamten Ablauf nach flüssigen Formulierungen zu beurteilen.
Was können die deutschen Benchmarks wirklich aussagen?
Aufgabe und Aufbau eines Benchmarks bestimmen die Aussage seines Wertes. OpenGPT-X nutzte in der Veröffentlichung 2024 maschinell übersetzte Fragen; EU MMLU setzte 2026 auf menschliche Übersetzung und Revision. Keine dieser Methoden bewertet allein die E-Mails Ihres Agenten.[4][5]
Lesen Sie die Methode vor dem Vergleich von Schlagzeilenwerten. Nutzen Sie den Benchmark für seine genannte Aufgabe und behalten Sie einen eigenen Abnahmetest für Ihre Korrespondenz.
| Quelle | Was sie tragen kann | Was sie nicht tragen kann |
|---|---|---|
| European LLM Leaderboard von OpenGPT-X (2024)[5] | Vergleich über 21 europäische Sprachen auf einheitlicher Grundlage | Eine Aussage über natürliches Deutsch — ARC, HellaSwag, TruthfulQA, GSM8K und MMLU wurden mit DeepL maschinell übersetzt |
| EU MMLU (GD Übersetzung, Juli 2026)[4] | Menschlich geprüfte mehrsprachige Evaluation, laut Ankündigung 16 EU-Sprachen, über 1.000 Fragen, rund 250 studentische Übersetzende aus 21 Universitäten | Ergebnisse für die kommerziellen Modelle, die Sie einsetzen würden — es ist ein Datensatz, keine Anbieterrangliste |
| LEXam (ICLR 2026)[3] | Juristische Argumentationsfähigkeit, je Sprache | Einen Abstand zwischen Deutsch und Englisch. Siehe unten |
| Studie zu Translationese (COLM 2026)[2] | Ob erzeugtes Deutsch die Spuren einer Übersetzung trägt | Einen allgemeinen Qualitätswert |
Maschinelle Übersetzung kann eigene Formulierungs- und Bedeutungsänderungen einführen. Die GD Übersetzung will mit menschlicher Übersetzung und Revision Bedeutung, Schwierigkeit und Prüfwert von EU MMLU sprachübergreifend erhalten. Das ist eine zu berücksichtigende Methode, kein veröffentlichtes Urteil über Ihr vorgesehenes kommerzielles Modell.[4][5]
LEXam nutzt unabhängige englische und deutsche Fragen aus verschiedenen Prüfungen statt paralleler Übersetzungen. Ein Wertunterschied vermischt daher Sprache und Frageninhalt. Daraus lässt sich kein isolierter Nachteil der deutschen Sprache bestimmen.[3]
Die Konventionen, die kein Benchmark prüft
Wissenswerte und juristische Argumentationswerte ersetzen nicht die Prüfung, wie Ihre eigenen Nachrichten die empfangende Person ansprechen. Legen Sie diese Konventionen fest und nehmen Sie sie in die Abnahme auf.
Siezen oder Duzen. Das Deutsche kennt eine Höflichkeitsunterscheidung, die das Englische nicht hat, und sie in einer Kunden-E-Mail falsch zu treffen ist ein echter Fehler ohne englische Entsprechung. Kein Wissensbenchmark prüft das. Es muss eine ausdrückliche Anweisung und ein Prüfpunkt sein — die deutschen Inhalte dieser Seite schreiben durchgängig das förmliche Sie als feste Regel vor, nicht als Vorliebe, die das Modell erschließen soll.
Anrede- und Grußformeln. Die deutsche Geschäftskorrespondenz hat eingespielte Formen. Ein Modell mit guten Werten bei deutschen Sachfragen kann einen Brief trotzdem so eröffnen, als wäre er auf Englisch verfasst worden.
Terminologie, die nicht übersetzt gehört. Produkt- und Werkzeugnamen bleiben im deutschen Geschäftstext englisch — Gmail, Slack, Notion. Ein Modell, das sie übersetzt, erzeugt Text, der grammatisch einwandfrei und für die Leserschaft sofort falsch ist.
Regionale Varianten. Österreichisches und Schweizer Deutsch unterscheiden sich im Wortschatz und, für die Schweiz, in der Orthografie. Nichts an der hier angeführten Evidenz hat das gemessen, und es wird dazu nichts behauptet.
Klare Anweisungen können helfen, garantieren aber keine Einhaltung jeder Konvention. Prüfen Sie die entstehenden Nachrichten und die für Ihre Kundschaft bedeutsamen Fehler. Dasselbe Prinzip gilt für Zuverlässigkeit allgemein.
So prüfen Sie das Deutsch Ihres Agenten für Kundenarbeit
Probieren Sie für eine erste Prüfung zwanzig repräsentative Nachrichten und eine muttersprachliche deutsche Prüfperson aus. Zwanzig ist ein vorgeschlagener Einstieg zur Fehlersuche, keine validierte Stichprobengröße oder Garantie für einen Abschluss an einem Nachmittag.
Zwanzig echte Nachrichten nehmen
Den Agenten seine Fassung schreiben lassen
Nur markieren, was vor dem Versand geändert würde
Die Änderungen auf zwei Stapel sortieren
Den Tokenunterschied am eigenen Text messen
Erfassen Sie Änderungen nach Art und Schwere. Testen Sie nach Anpassungen erneut, ergänzen Sie ungewöhnliche Fälle und verlangen Sie menschliche Freigabe, wo eine falsche Nachricht schaden kann. Eine kleine erste Prüfung kann Probleme aufdecken, bestimmt aber weder seltene Fehlerquoten noch die Versandbereitschaft jeder Kundennachricht.
Was die Tokenzahlen nicht zeigen
Die Tokenmessung betrifft einen festen Veröffentlichungsstand mit 63 Paaren. Sie kontrolliert weder identischen Wortlaut noch Textlänge oder Entstehung beider Sprachfassungen. Behandeln Sie sie als datierte Messung dieses Bestands und messen Sie Ihre eigenen Vorgänge vor der Budgetplanung.[1]
Die menschliche Annotation der Translationese-Studie ist klein und nutzt Autoren als Prüfpersonen. Sie ergänzt die automatische Analyse, liefert aber kein allgemeines Urteil zur Geschäftskorrespondenz. Eine andere Studie zu Übersetzungssystemen führt Translationese auf Verzerrungen beim überwachten Training zurück; diese Übersetzungsaufgabe unterscheidet sich vom Verfassen Ihrer Kundennachrichten.[2][6]
Nichts hiervon betrifft Übersetzungsqualität, die eine andere Aufgabe ist als Erzeugung. Nichts betrifft österreichisches oder Schweizer Deutsch. Und nichts hat gesprochenes Deutsch oder Transkription gemessen, wo die Grenzen des Lesbaren eine eigene Frage mit eigener Evidenz sind.
Die Bestandswerte zeigen, warum Tokenzahlen zählen. Die Forschungsmethoden zeigen, warum ein Benchmark-Wert keinen Kundentexttest ersetzt. Ihre praktische Entscheidung braucht das tatsächliche Modell, die tatsächliche Korrespondenz und eine Prüfung von Fakten ebenso wie von Formulierungen.
Häufig gestellte Fragen
Schreiben KI-Modelle so gut Deutsch wie Englisch? Testen Sie Ihre tatsächlichen Geschäftstexte, statt Gleichwertigkeit vorauszusetzen. Die Translationese-Studie 2026 fand Unterschiede zwischen automatischer und menschlicher Einstufung bestimmter Gemini- und Llama-Ausgaben mit kleinen menschlichen Prüfmengen. Das ist kein allgemeiner Qualitätswert Deutsch gegen Englisch. Prüfen Sie Formulierung, Fakten und Anrede getrennt.[2]
Warum kostet Deutsch bei einem KI-Agenten mehr als Englisch? Im festen Yardwork-Bestand mit 63 Paaren brauchte Deutsch unter o200k im Median 21,5 % mehr Tokens bei rund 9 % weniger Wörtern. Encoding und Texte bestimmen das Verhältnis. Das ist weder ein allgemeiner Deutschaufschlag noch ein Maß für die gesamte Agentenrechnung.[1][8]
Gibt es einen Benchmark, der die Deutschqualität von KI zeigt? Es gibt Benchmarks für bestimmte Aufgaben. OpenGPT-X nutzte mit DeepL übersetzte Fragen über 21 Sprachen; EU MMLU nutzte menschliche Übersetzung und Revision für 1000+ Fragen mit fast 250 Studierenden aus 21 Universitäten und nannte 16 EU-Sprachen. Der Aufbau zählt; keiner ersetzt Tests Ihrer Kundennachrichten.[4][5]
Siezt oder duzt ein KI-Agent auf Deutsch? Geben Sie gewünschte Anrede, Grußformel und Fachbegriffe ausdrücklich vor und prüfen Sie die Einhaltung im Ergebnis. Ein Wissenswert beantwortet nicht, ob das Modell diesen Kunden angemessen anspricht.
Wie prüfe ich, ob das Deutsch eines KI-Agenten für meine Kundschaft ausreicht? Probieren Sie zwanzig repräsentative frühere Nachrichten als Einstieg aus, nicht als validierte Stichprobengarantie. Lassen Sie notwendige Änderungen muttersprachlich markieren, trennen Sie Wortwahl von Fakten- oder Aufgabenfehlern und testen Sie nach Anpassungen erneut. Ergänzen Sie ungewöhnliche Fälle vor der Live-Freigabe.
Quellen
- Yardwork bilingual corpus token measurement. 24. August 2026 Bestandsstand; reproduziert 15. Oktober 2026 Abgerufen am 15. Oktober 2026.
- An Investigation of Translationese in the Generations of Multilingual Large Language Models. 18. August 2026 Abgerufen am 15. Oktober 2026.
- LEXam: Benchmarking Legal Reasoning on 340 Law Exams. 2. April 2026 Fassung Abgerufen am 15. Oktober 2026.
- Towards fair multilingual AI: EU MMLU, a new EU benchmark for LLMs. 22. Juli 2026 Abgerufen am 15. Oktober 2026.
- European LLM Leaderboard. 12. Juli 2024 Abgerufen am 15. Oktober 2026.
- Lost in Literalism: How Supervised Training Shapes Translationese in LLMs. 6. März 2025 Abgerufen am 15. Oktober 2026.
- tiktoken. Fortlaufendes Repository; Tokenizer-Version 0.14.0 verwendet Abgerufen am 15. Oktober 2026.
- API pricing. Fortlaufende Preisübersicht, Oktober 2026 Abgerufen am 15. Oktober 2026.
