Eine KI-Wissensdatenbank beantwortet Fragen aus den eigenen Dokumenten eines Unternehmens, und sie liegt trotzdem falsch. In einer vorab registrierten Stanford-Studie vom Mai 2024 erfanden kommerzielle juristische Rechercheprogramme, die aus geprüften Quellen antworten, bei 17 bis 33 % der Testfragen Inhalte. Die Zahlen gelten für drei juristische Programme und 202 Fragen, nicht für jedes Produkt. Die Fehlerstellen, die sie zeigen, betreffen aber jeden Assistenten, der aus Dateien antwortet: Das richtige Dokument fehlt oder ist veraltet, die falsche Passage wird gefunden, die Antwort geht über die Quelle hinaus, oder das Programm zeigt jemandem eine Datei, die er nicht sehen sollte. Dieser Artikel belegt jede Fehlerstelle mit datierten Quellen und nennt einen Test, bevor sich Beschäftigte oder Kunden auf die Antworten verlassen.
Eine KI-Wissensdatenbank ist ein Assistent, der Fragen aus den eigenen Dokumenten Ihres Unternehmens beantwortet: Handbücher, Verträge, Projektakten, Produktblätter und Richtlinien. Er durchsucht die Dateien, sobald eine Frage eingeht, und schreibt eine Antwort aus dem, was er findet.
Dieser Aufbau verringert erfundene Antworten. Er beseitigt sie nicht. Dieser Artikel nimmt die datierten Belege dafür, wo Antworten aus Dokumenten scheitern, und macht daraus Korrekturen und einen Test, den Sie vor dem Start durchführen können.
Gibt eine KI-Wissensdatenbank korrekte Antworten aus Ihren Dokumenten?
Nicht zuverlässig. Die beste datierte Messung ist die Stanford-Studie von 2024 zu kommerziellen juristischen Rechercheprogrammen, die aus geprüften Quellen antworten: Lexis+ AI, Westlaw AI-Assisted Research und Ask Practical Law AI „each hallucinate between 17% and 33% of the time“ bei 202 vorab registrierten Fragen, veröffentlicht am 30. Mai 2024.[¹] Das beste davon, Lexis+ AI, beantwortete 65 % der Fragen korrekt und mit belegender Quelle.[¹]
Diese Programme wurden mit dem Versprechen verkauft, dass Antworten aus Dokumenten das Problem lösen. Die Studie zitiert die Anbieter selbst mit „eliminating“ und „hallucination-free“.[¹] Die Programme erfanden weniger als GPT-4 allein. Aufgehört haben sie nicht.
Die Studie betrifft juristische Recherche, drei Produkte und einen Zeitpunkt. Sie ist keine Fehlerquote für Ihre Wissensdatenbank. Sie belegt, dass das Verfahren allein keine korrekten Antworten garantiert, selbst wenn ein großes Unternehmen die Quellen pflegt.
Das Verfahren hinter den meisten Wissensdatenbanken heißt Retrieval-Augmented Generation: Dokumente durchsuchen, die gefundenen Passagen an die KI übergeben und sie die Antwort schreiben lassen. Jeder dieser drei Schritte kann auf eigene Weise scheitern.
Warum antwortet eine KI aus Ihren eigenen Dokumenten falsch?
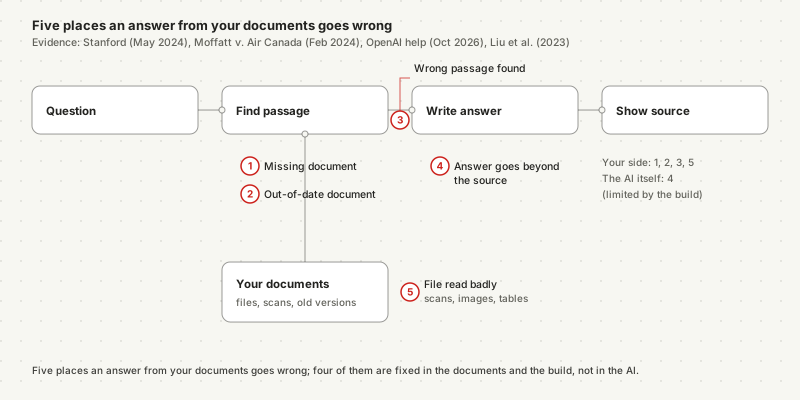
Antworten aus Dokumenten scheitern an fünf Stellen, und vier davon liegen auf der Seite des Unternehmens. Die Stanford-Studie, die Entscheidung im Fall Air Canada vom 14. Februar 2024 und OpenAIs veröffentlichte Dateigrenzen, aktualisiert im Oktober 2026, zeigen jeweils eine dieser Stellen in einem echten Produkt.[¹][²][⁵]
| Fehlerstelle | Was passiert | Datierter Beleg |
|---|---|---|
| Das Dokument fehlt | Keine Datei enthält die Antwort, und die KI rät, statt das zu sagen | Stanford trennte Verweigerungen und unbelegte Antworten von falschen: Ask Practical Law AI lieferte das eine oder andere bei mehr als 60 % der Fragen (2024)[¹] |
| Das Dokument ist veraltet oder widerspricht einem anderen | Zwei Quellen widersprechen sich, und die KI wählt die falsche | Der Chatbot von Air Canada widersprach Air Canadas eigener Richtlinienseite (2024)[²] |
| Die falsche Passage wird gefunden | Die Suche liefert einen Beinahe-Treffer, und die Antwort baut darauf auf | Modelle nutzten Informationen in der Mitte langer Eingaben weniger zuverlässig (Studie von 2023)[⁴] |
| Die Antwort geht über die Quelle hinaus | Die KI fügt eine Aussage hinzu, die in der Passage nicht steht | Stanford zählt Antworten, die „falsely assert a source supports a statement“, als erfunden[¹] |
| Die Datei wird schlecht gelesen | Scans, Bilder und Tabellen verlieren beim Einlesen ihren Inhalt | Außerhalb von ChatGPT Enterprise liest ChatGPT nur den digitalen Text einer Datei, nicht eingebettete Bilder (Oktober 2026)[⁵] |
Die ersten beiden sind Dokumentprobleme: Beheben Sie sie vor dem Start. Die dritte hängt vom Aufbau ab, der bestimmt, wie Passagen gefunden werden. Die vierte ist ein Fehler der KI selbst; der Aufbau kann ihn nur begrenzen, indem er „Das weiß ich nicht“ verlangt, wenn nichts passt. Die fünfte behandelt unser Leitfaden, was KI aus Ihren Dokumenten lesen kann und was nicht.
Beweist eine Quellenangabe, dass die Antwort stimmt?
Nein. Eine Quellenangabe zeigt, wo die KI nachgesehen hat, nicht, ob sie die Quelle richtig gelesen hat. Die Stanford-Studie von 2024 zählt Antworten, die „falsely assert a source supports a statement“, als erfunden, und im Fall Moffatt gegen Air Canada, entschieden am 14. Februar 2024, verlinkte der Chatbot der Airline genau die Seite, die seiner Antwort widersprach.[¹][²]
Die Fakten im Fall Air Canada sind konkret. Der Chatbot sagte einem Kunden, er könne einen Trauerfall-Tarif auch nach der Reise beantragen, „within 90 days of the date your ticket was issued“. Die Wörter „bereavement fares“ in dieser Antwort waren ein Link auf Air Canadas Seite „Bereavement travel“. Dort stand, dass der ermäßigte Tarif nach abgeschlossener Reise nicht gilt.[²]
Der Chatbot von Air Canada verlinkte die Richtlinienseite, die seine Antwort widerlegte. Eine Quellenangabe ist ein Ort zum Prüfen, keine Prüfung.
Für eine Wissensdatenbank ändert das, was „zeigt ihre Quellen“ wert ist. Quellen machen eine Prüfung möglich. Sie helfen nur, wenn jemand prüft; deshalb gehört zum Test weiter unten, bei einer Stichprobe jede zitierte Passage zu öffnen.
Das Tribunal wies auch Air Canadas Einwand zurück, der Chatbot sei für seine Worte selbst verantwortlich: „It makes no difference whether the information comes from a static page or a chatbot.“[²]
Kann eine KI-Wissensdatenbank Beschäftigten Dokumente zeigen, die sie nicht sehen dürfen?
Ja. Eine KI-Wissensdatenbank kann jedes Dokument zeigen, das ihr Konto lesen darf, und sie macht zu weit freigegebene Dateien leicht auffindbar. Microsoft schreibt, Copilot „only surfaces organizational data to which individual users have at least view permissions“, und sein Copilot-Bereitstellungsplan, aktualisiert am 18. August 2026, beginnt mit dem Schritt „Remediate oversharing“.[⁶][⁷]
Eine Wissensdatenbank antwortet aus allem, was ihr Konto lesen kann. Liest sie Ihre Dateien über ein gemeinsames Konto, erreicht jede Person, die ihr eine Frage stellen kann, jedes Dokument dahinter.
Hier stecken zwei getrennte Probleme. Das erste ist der Aufbau: Eine Wissensdatenbank, die das ganze Laufwerk mit Administratorrechten einliest, antwortet allen mit dem Wissen eines Administrators. Das zweite sind die Dateien: Eine Gehaltsliste, die vor Jahren für „alle im Unternehmen“ freigegeben wurde, war bisher schwer zu finden. Eine Suche, die jede Datei liest, findet sie in Sekunden.
Microsofts Leitfaden behandelt das zweite Problem als erste Aufgabe, bevor Copilot eingeschaltet wird: risikoreiche Websites und Dateien finden, den Zugriff bei Bedarf einschränken, dann die Freigaben bereinigen.[⁷] Unser Leitfaden zu Microsoft Copilot und der DSGVO zeigt, was das für den Datenschutz bedeutet.
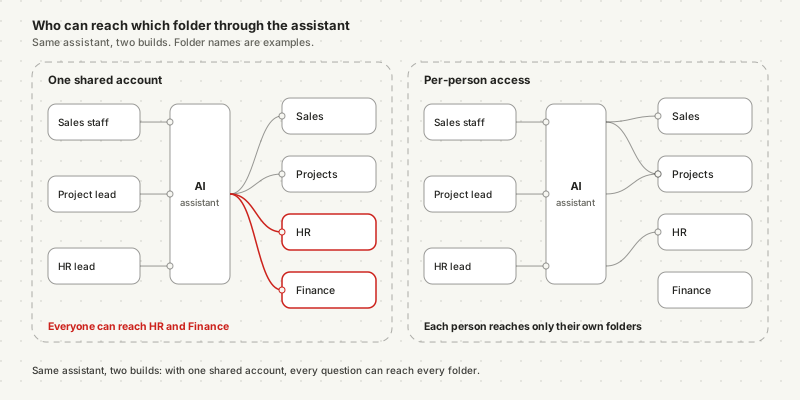
Der richtige Aufbau reicht die Berechtigungen jeder Person an die Suche weiter. Unser Überblick, worauf ein KI-Agent in Gmail, Drive, Slack und Microsoft 365 zugreifen kann, zeigt, wie diese Berechtigungen vergeben werden.
Welche Grenzen setzen ChatGPT und Copilot bei Unternehmensdokumenten?
Fertige Assistenten begrenzen, wie viele Dokumente eine Wissensdatenbank fassen kann und wie diese Dateien gelesen werden. OpenAIs Hilfeseite, aktualisiert im Oktober 2026, erlaubt bei ChatGPT Business bis zu 40 Dateien pro Projekt und bis zu 10 Wissensdateien pro eigenem GPT, „for the lifetime of that GPT“.[⁵]
| Werkzeug und Tarif | Wie viele Dokumente | Wie Dateien gelesen werden | Quelle |
|---|---|---|---|
| ChatGPT-Projekte (Business, Enterprise, Pro, Edu) | Bis zu 40 Dateien pro Projekt | Außerhalb von Enterprise nur Text | OpenAI, Oktober 2026[⁵] |
| Wissen eines eigenen GPT | Bis zu 10 Dateien, für die Lebensdauer des GPT | Außerhalb von Enterprise nur Text | OpenAI, Oktober 2026[⁵] |
| ChatGPT, jede Datei | 2 Millionen Tokens pro Text- oder Dokumentdatei | Enterprise liest PDFs zusätzlich visuell | OpenAI, Oktober 2026[⁵] |
| Microsoft Copilot | Alles, was die Person in Microsoft 365 öffnen kann | Über die Berechtigungen in Microsoft 365 | Microsoft, aktualisiert Oktober 2026[⁶] |
Vierzig Dateien sind ein Projektordner, kein Unternehmenshandbuch samt allen Verträgen. Ein Unternehmen mit einigen hundert Dokumenten wächst schnell aus einem ChatGPT-Projekt heraus und beginnt auszuwählen, welche Dateien draußen bleiben, und damit kehrt der Fehler „Dokument fehlt“ zurück.
Auch die Länge der Eingabe zählt. Die Studie „Lost in the Middle“ von 2023 fand, dass Sprachmodelle Informationen „at the beginning or end of the input context“ zuverlässiger nutzten als Informationen in der Mitte langer Eingaben.[⁴] Die Studie maß Modelle von 2023, aber ihr Befund ist ein Grund, warum ein guter Aufbau der KI wenige passende Passagen schickt, nicht den ganzen Ordner.
Was sollten Sie vor dem Start an Ihren Dokumenten korrigieren?
Korrigieren Sie zuerst die Dokumente, denn eine Wissensdatenbank wiederholt, was darin steht. Der Fall Air Canada vom 14. Februar 2024 drehte sich um zwei Seiten desselben Unternehmens, die sich widersprachen; das Tribunal machte das Unternehmen für beide verantwortlich.[²] Vier Korrekturen decken den größten Teil des Risikos ab:
- Eine aktuelle Fassung pro Thema. Verschieben Sie alte Preislisten, abgelaufene Richtlinien und ersetzte Vorlagen aus den Ordnern, die die Wissensdatenbank liest.
- Eine verantwortliche Person und ein Datum je Dokument. Ist eine Antwort falsch, muss jemand wissen, welche Datei zu korrigieren ist und wann sie zuletzt geprüft wurde.
- Ein schriftlicher Umfang. Legen Sie fest, welche Fragen die Wissensdatenbank beantworten darf — interne Personalrichtlinien, Produktdaten, Projekthistorie — und welche sie ablehnen muss, etwa Rechts- oder Gesundheitsfragen.
- Saubere Freigaben. Entfernen Sie Freigaben für „alle“ auf sensiblen Ordnern, bevor Sie etwas anbinden, wie es Microsofts eigener Copilot-Plan empfiehlt.[⁷]
Keine dieser Korrekturen braucht die KI. Es ist dieselbe Arbeit, die eine neue Mitarbeiterin bräuchte, um die richtige Antwort zu finden: einmal erledigt und dann gepflegt.
Gescannte oder fotografierte Dokumente brauchen einen weiteren Schritt: Prüfen Sie, ob ihr Text überhaupt lesbar ist, sonst findet die Suche nie, was darin steht.
Wie testen Sie eine KI-Wissensdatenbank vor dem Start?
Testen Sie mit echten Fragen, auch mit solchen, die Ihre Dokumente nicht beantworten können, bevor sich jemand auf die Antworten verlässt. Das Stanford-Team hat seine Auswertung von 2024 genauso angelegt: ein fester, vorab registrierter Fragenkatalog und eine schriftliche Festlegung, was als falsche Antwort zählt.[¹] Die Schritte unten sind unsere Methode, abgeleitet aus diesen Belegen; sie sind kein Branchenstandard.
Echte Fragen sammeln
Unbeantwortbare Fragen ergänzen
Quellen einer Stichprobe prüfen
Ein veraltetes Dokument einschleusen
Berechtigungstest mit zwei Personen
Nach jeder Änderung wiederholen
Die einseitige Checkliste enthält diese sechs Schritte und die Dokumentkorrekturen oben: Checkliste zum Test einer KI-Wissensdatenbank herunterladen (PDF).
Sollten Kunden direkt Antworten daraus erhalten?
Erst, wenn der interne Test bestanden ist, und mit einer Person, die bei wichtigen Antworten prüft, was hinausgeht. Zwei öffentliche Fälle zeigen den Preis: Air Canada wurde am 14. Februar 2024 wegen einer Chatbot-Antwort zur Zahlung von 812,02 kanadischen Dollar verurteilt, und der Chatbot MyCity der Stadt New York sagte Unternehmen im März 2024, sie dürften Bargeld ablehnen, entgegen einem städtischen Gesetz von 2020.[²][³]
Der Chatbot von New York lief auf den Azure-KI-Diensten von Microsoft und sollte laut Ankündigung auf „more than 2,000 NYC Business web pages“ zugreifen.[³] Amtliche Quellen hielten ihn nicht davon ab, Ratschläge zu geben, die gegen die Regeln der Stadt verstießen. Die Stadt nannte ihn ein Pilotprojekt, das besser werde.[³]
Antworten an Kunden verändern das Risiko auf zwei Arten. Eine falsche interne Antwort erreicht eine Kollegin, die es bemerken kann. Eine falsche Antwort an einen Kunden ist eine Aussage des Unternehmens, wie das Tribunal im Fall Air Canada festhielt.[²] Und Kunden können eine aktuelle Quelle nicht von einer alten unterscheiden.
Ein individueller Agent, der für diese Aufgabe gebaut ist, antwortet jeder Person nur aus Dokumenten, die sie öffnen darf, zeigt die Passage hinter jeder Antwort und hält Antworten an Kunden zur Freigabe zurück, bevor sie versendet werden, wo es darauf ankommt. Rutscht doch eine falsche Antwort durch, zeigt unser Leitfaden, was zu tun ist, wenn ein KI-Agent einen Fehler macht.
Häufig gestellte Fragen
Wie genau ist eine KI-Wissensdatenbank? Eine einzelne Zahl gibt es nicht. Die beste datierte Messung ist eine Stanford-Studie von 2024 zu drei kommerziellen juristischen Rechercheprogrammen, die aus geprüften Quellen antworten: Sie erfanden bei 17 bis 33 % von 202 Testfragen Inhalte, das beste Programm antwortete in 65 % der Fälle zutreffend. Wie genau eine Wissensdatenbank im Unternehmen ist, hängt davon ab, wie aktuell und vollständig die Dokumente sind und wie sie vor dem Start getestet wird.
Muss ich eine KI mit meinen Unternehmensdokumenten trainieren? Meist nicht. Die meisten KI-Wissensdatenbanken lassen das Modell unverändert, durchsuchen Ihre Dokumente im Moment der Frage und schreiben die Antwort aus den gefundenen Passagen. Das Verfahren heißt Retrieval-Augmented Generation. Ein korrigiertes Dokument ändert so die nächste Antwort ohne neues Training, aber die Antwort ist nur so gut wie die Passage, die die Suche findet.
Kann eine KI-Wissensdatenbank Beschäftigten Dateien zeigen, die sie nicht sehen dürfen? Ja, wenn sie Dokumente mit einem gemeinsamen Konto liest oder Dateien schon zu weit freigegeben sind. Microsoft schreibt, Copilot zeige nur Daten, die eine Person ohnehin öffnen darf, und sein Copilot-Bereitstellungsplan, aktualisiert im August 2026, beginnt mit dem Abbau übermäßiger Freigaben. Eine Wissensdatenbank sollte jeder Person nur aus Dokumenten antworten, die diese Person öffnen darf.
Haftet ein Unternehmen für falsche Antworten seines KI-Chatbots? Ein Tribunal hat ein Unternehmen dafür verantwortlich gemacht. Im Fall Moffatt gegen Air Canada, entschieden am 14. Februar 2024, wies ein Tribunal in British Columbia das Argument zurück, der Chatbot sei für seine Antworten selbst verantwortlich, und verurteilte Air Canada zur Zahlung von 812,02 kanadischen Dollar. Das ist eine kanadische Entscheidung, kein europäisches Recht; fragen Sie zu Ihrem Fall eine Anwältin oder einen Anwalt.
Quellen
- Magesh, Surani, Dahl, Suzgun, Manning und Ho, Hallucination-Free? Assessing the Reliability of Leading AI Legal Research Tools, arXiv:2405.20362, 30. Mai 2024, abgerufen am 13. Oktober 2026. Verwendet für die Spanne von 17 bis 33 %, 65 % Genauigkeit bei Lexis+ AI, über 60 % unvollständige Antworten bei Ask Practical Law AI, die Versprechen der Anbieter und die Definition erfundener Antworten.
- Civil Resolution Tribunal of British Columbia, Moffatt v. Air Canada, 2024 BCCRT 149, 14. Februar 2024, Randnummern 15–17, 27, 28 und 44, abgerufen am 13. Oktober 2026.
- The Markup, NYC's AI chatbot tells businesses to break the law, Colin Lecher, 29. März 2024, abgerufen am 13. Oktober 2026.
- Liu u. a., Lost in the Middle: How Language Models Use Long Contexts, arXiv:2307.03172 v3, 20. November 2023, Transactions of the Association for Computational Linguistics, abgerufen am 13. Oktober 2026.
- OpenAI Help Center, Uploading files and audio to ChatGPT, aktualisiert im Oktober 2026, abgerufen am 13. Oktober 2026. Verwendet für Datei-Grenzen bei Projekten und GPTs, die Token-Grenze pro Datei und die reine Textauswertung außerhalb von Enterprise.
- Microsoft Learn, Data, Privacy, and Security for Microsoft Copilot, aktualisiert am 8. Oktober 2026, abgerufen am 12. Oktober 2026.
- Microsoft Learn, Secure & Governed Data Foundation for Microsoft Copilot, 6. Mai 2026, aktualisiert am 18. August 2026, abgerufen am 13. Oktober 2026.